Aprender AI-DLC creando un juego, parte 10: esqueleto funcional
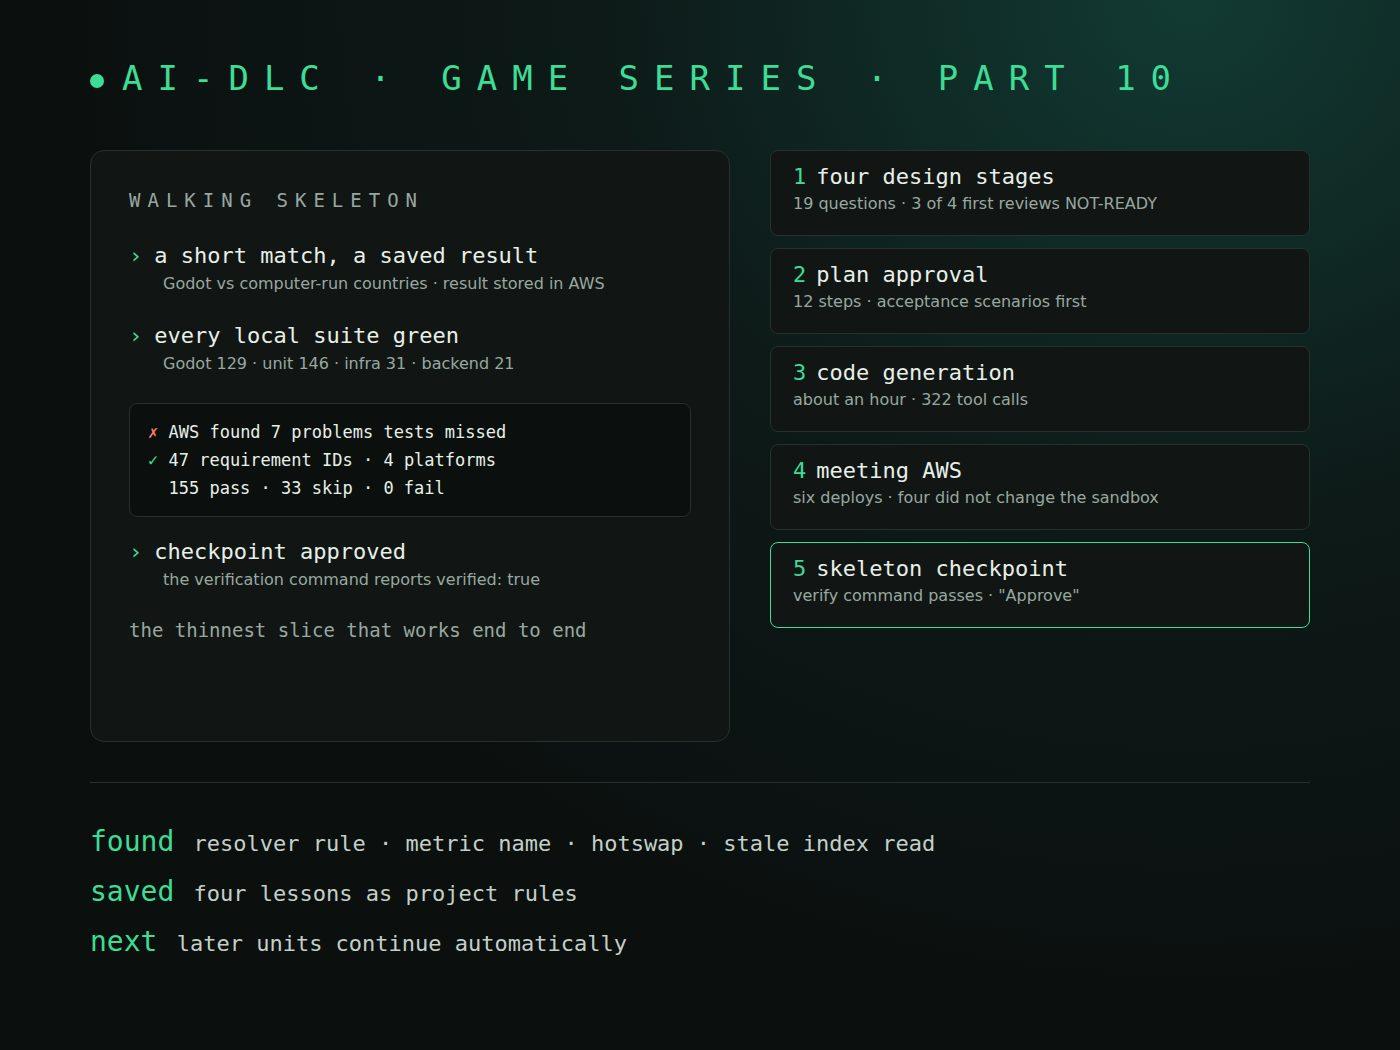
Esta es la parte 10 de una serie sobre aprender AI-DLC creando un juego, World Rift Conflict, en Godot con un backend en AWS. La parte 8 planificó el trabajo, y la parte 9 contó un error de despliegue de la mitad de este artículo. Este artículo cubre toda la primera unidad: el esqueleto funcional, desde su diseño hasta mi aprobación.
Partes hasta ahora:
- Parte 1: configuración
- Parte 2: prueba de concepto
- Parte 3: pruebas E2E automatizadas
- Parte 4: lo que hallaron las revisiones
- Parte 5: dentro de una etapa
- Parte 6: un bugfix
- Parte 7: ideación
- Parte 8: incepción
- Parte 9: un error de AppSync
- Parte 10: esqueleto funcional (este artículo)
Resumen
- El scope
mvpdeclaraskeleton: on, así que la primera unidad pasa por todas las etapas de diseño y por Code Generation antes de que empiece cualquier otra unidad, y termina en un checkpoint humano. - Cuatro etapas de diseño hicieron 19 preguntas más una de seguimiento. Tres de las cuatro primeras revisiones dijeron NOT-READY.
- Code Generation construyó la unidad en una hora aproximadamente y 322 llamadas a herramientas. Todas las suites locales pasaron.
- El backend real aun así encontró siete problemas que las pruebas locales no podían ver, desde una regla de resolvers en AppSync hasta un nombre de métrica que no existe.
- La ejecución final pasó 47 IDs de requisitos en cuatro plataformas con 0 fallos. Aprobé el esqueleto y dejé que las unidades siguientes continúen automáticamente.
Qué es un esqueleto funcional en AI-DLC
Un esqueleto funcional (walking skeleton) es la porción más delgada de un producto que funciona de punta a punta. Para este juego es una partida corta contra países controlados por la computadora en la versión web, más el resultado del jugador conectado guardado en el backend. Las partidas en línea en vivo no forman parte de él.
En AI-DLC es más que un hábito. El scope mvp declara skeleton: on, y Construction avanza unidad por unidad con los checkpoints activados. Así que la primera unidad, u1-skeleton-match, pasa por todas las etapas por unidad, Code Generation incluida, antes de que empiece cualquier unidad posterior.
Estas etapas de unidad no tienen una puerta de aprobación propia. Cada una se revisa y se registra como completa. La aprobación llega una sola vez, en el checkpoint del esqueleto, y solo después de que pase el Construction Verification Command. Ese comando se aprobó durante la planificación de la entrega:
npm test && npm run lint && npm run check:backend && npm run check:secrets && npm run e2e
La última parte, npm run e2e, ejecuta el juego contra un backend de prueba real en AWS. Una primera revisión de una etapa de diseño no puede reemplazarla.
Cuatro etapas de diseño
Cada etapa hizo sus preguntas, yo confirmé un resumen ("Looks correct"), el agente escribió los artefactos y un revisor los comprobó.
Functional design hizo seis preguntas sobre el juego en sí. La puntuación es el crecimiento desde el punto de partida del propio país, en porcentaje. El jugador reparte 100 puntos entre prioridades. La computadora elige "Whatever raises its score most this round". El esqueleto tiene 4 países y 2 eventos, y una ronda dura 60 segundos. El resultado fueron 24 reglas, de BR1.1 a BR9.2. La primera revisión dijo NOT-READY con 4 hallazgos Major: volver a abrir la tarjeta del país no estaba cubierto en ningún lugar, abandonar una partida no estaba modelado, los eventos no tenían objetivo y la forma de Country no coincidía con el contrato aprobado. Todos se corrigieron, y la segunda revisión dijo READY.
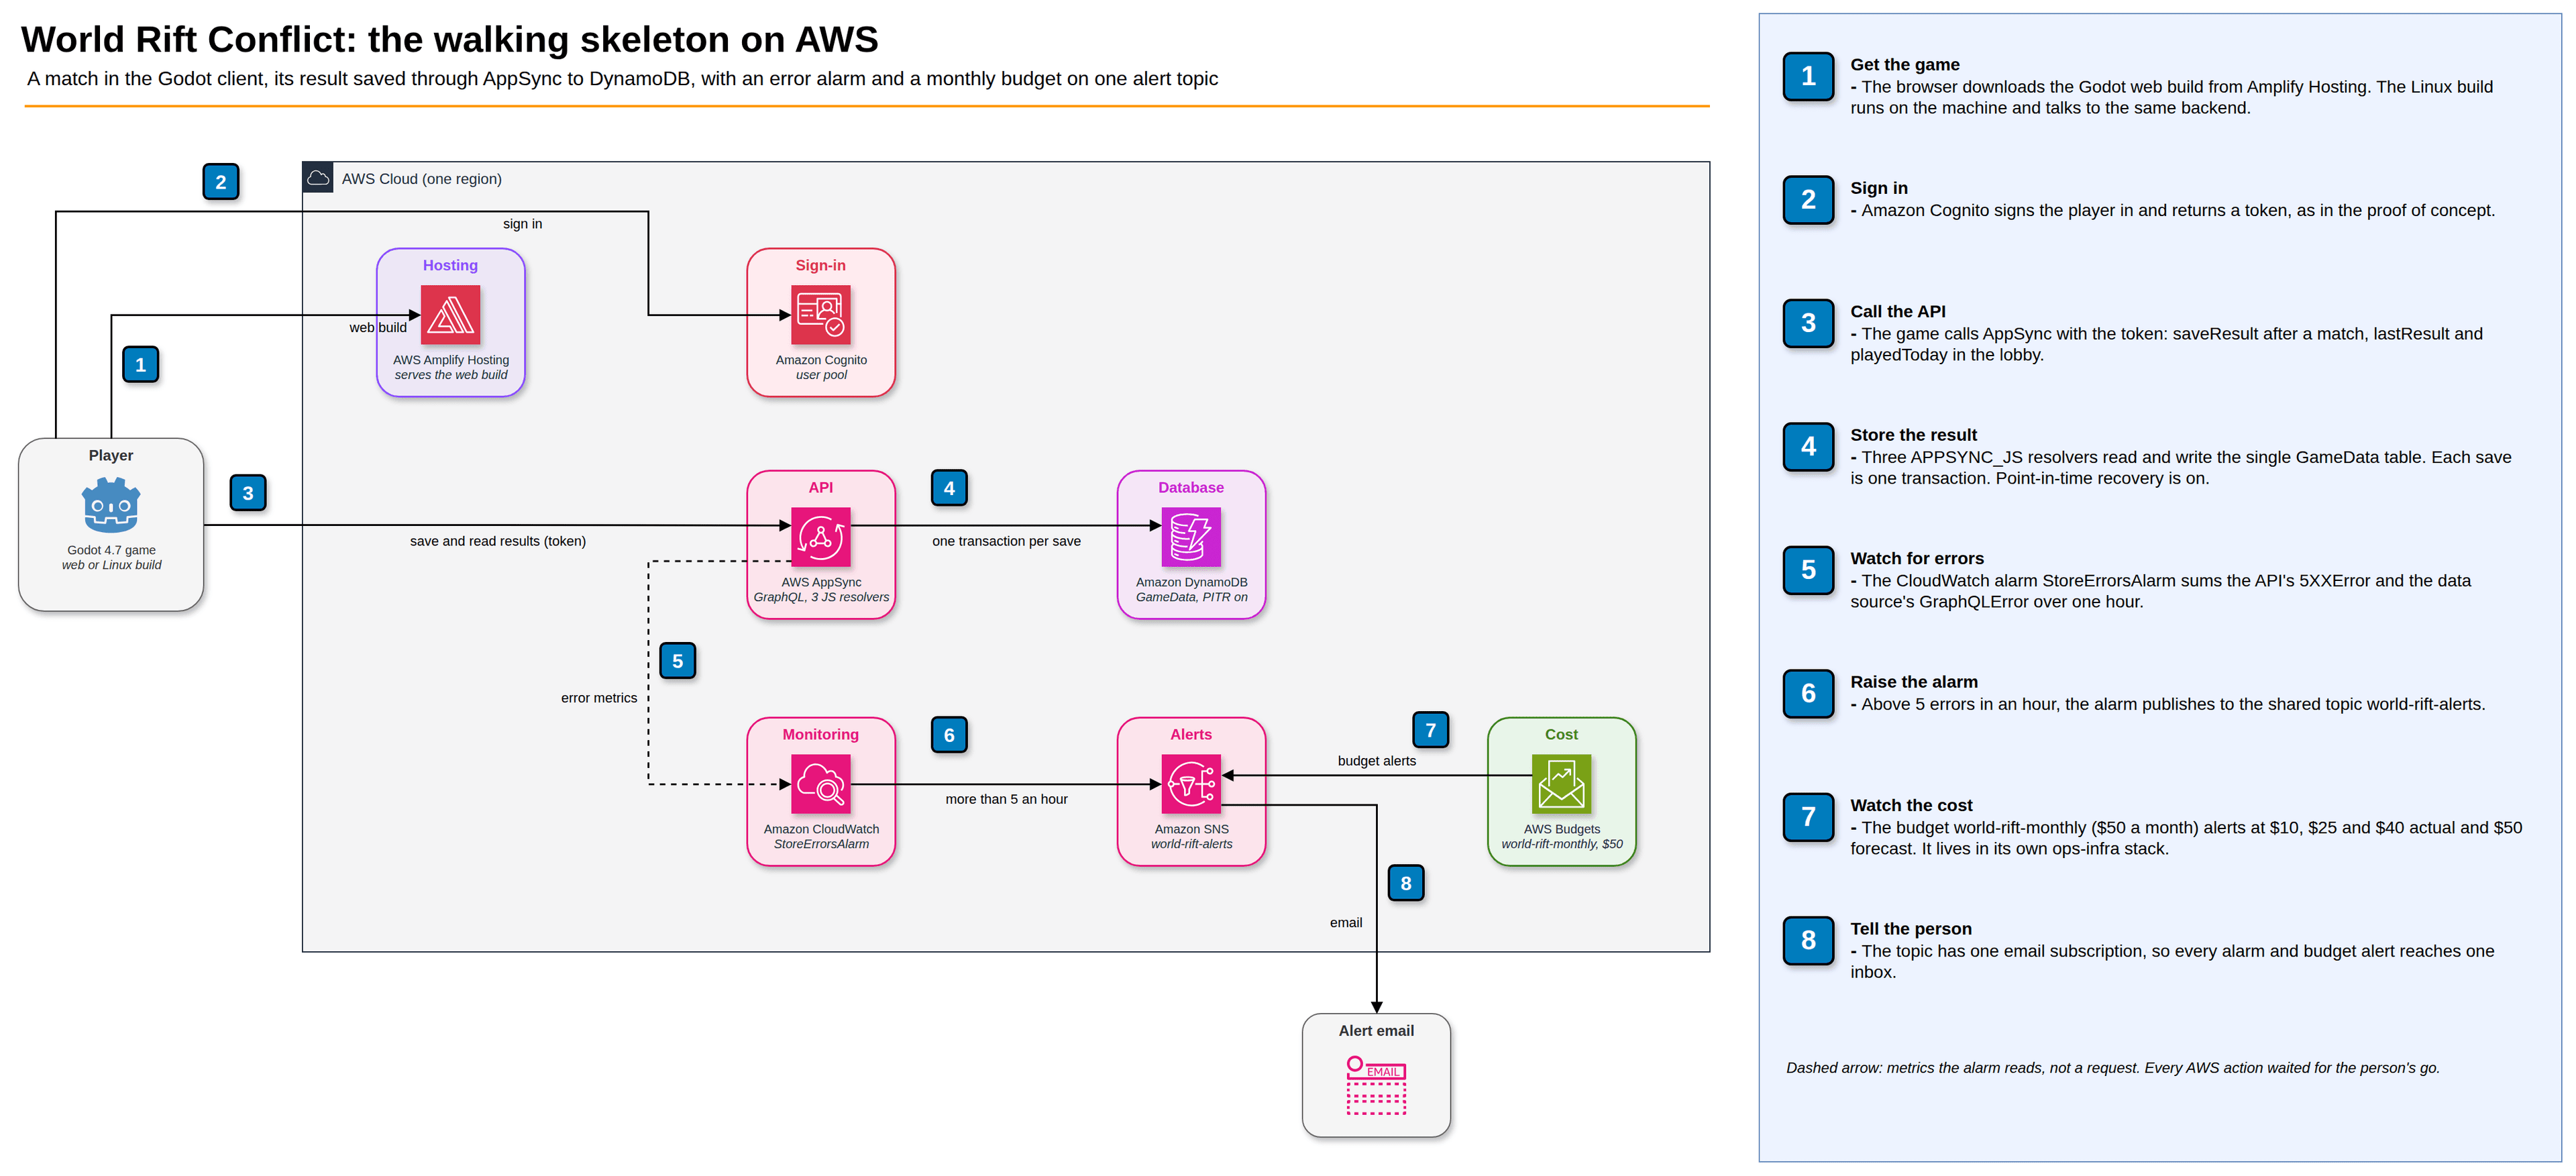
NFR requirements hizo seis preguntas, y elegí la respuesta recomendada cada vez. El almacén de resultados es Amplify Gen 2 data: una API GraphQL de AppSync sobre DynamoDB. Un resultado no guardado se queda en el dispositivo. Las alertas de gasto saltan a $10, $25 y $40 reales y $50 previstos, y una alarma salta por encima de 5 errores del almacén por hora. La revisión dijo READY pero planteó 2 hallazgos Major. Uno era que un resultado en espera en un dispositivo compartido no tiene dueño, así que un segundo jugador podría recibirlo.
NFR design hizo cuatro preguntas. Cada guardado ejecuta una transacción de base de datos, y cada resultado en espera lleva el id de usuario de su dueño. La primera revisión dijo NOT-READY con 3 hallazgos Major, y la segunda dijo READY. Quedaron dos incógnitas como comprobaciones para después: cómo cuenta los errores la métrica de errores de la API, y si los guardados repetidos se resuelven a tiempo.
Infrastructure design hizo tres preguntas: una app CDK aparte para el stack de alertas, un único tema de alertas compartido y protección contra borrado solo en las tablas de producción. La primera revisión dijo NOT-READY con 3 hallazgos Major. El más útil fue que "alertas antes de costos" no tenía una puerta mecánica. La solución fue un comando de solo lectura, npm run ops:check-alerts, que debe pasar antes de desplegar el backend de prueba.
La segunda revisión pilló entonces al propio agente. La revisión había pasado a una sola tabla, GameData, cuando yo había confirmado dos, y nadie me había preguntado. AI-DLC hizo una pregunta de seguimiento, y elegí "A. One table".
Code Generation
Code Generation empieza con Plan Approval. Hasta que aprobé el plan, el motor bloqueó todos los comandos de shell que podían cambiar archivos:
Code generation cannot run mutation-capable shell commands for unit u1-skeleton-match because the plan, unit-test instructions, and current Testing Contract do not have a current matching approval.
El plan tenía 12 pasos y ponía primero los escenarios de aceptación, el orden que piden nuestras prácticas: primero las comprobaciones de aceptación, después las pruebas unitarias. Antes de escribirlo, el agente nombró los patrones de Godot que eligió y los que rechazó. Eligió una escena por pantalla bajo una raíz de composición, no una gran escena de panel. Eligió una máquina de estados con enum, no un nodo por estado. Respondí "Approve Plan".
El agente desarrollador construyó entonces los 12 pasos. Le llevó una hora aproximadamente y 322 llamadas a herramientas. La comprobación pre-push pasó sus nueve pasos:
| Suite | Resultado |
|---|---|
| Godot (gdUnit4) | 129 casos de prueba, 0 fallos (100 nuevos) |
| Pruebas unitarias TypeScript | 146 pasan |
| Pruebas de infraestructura | 31 pasan |
| Pruebas del backend | 21 pasan |
| Cobertura de líneas del TypeScript nuevo | de 81,6% a 100% por archivo |
La revisión de código dijo READY con 5 hallazgos Minor. Los dos escenarios de aceptación se escribieron pero no se ejecutaron, porque necesitan AWS.
El encuentro con AWS
Cada acción en AWS espera mi visto bueno. Antes de pedirlo, el agente comprueba en modo de solo lectura qué puede hacer mi rol. Esa comprobación encontró que mi rol de acceso de Amplify no podía leer temas de SNS, AWS Budgets ni alarmas de CloudWatch, así que la puerta de alertas nunca podría pasar. Añadí una pequeña política de lectura en línea. El stack de alertas se desplegó, y la puerta falló una vez más, con razón, porque todavía no había confirmado el correo de alertas.
Luego empezaron los despliegues del backend de prueba, y las sorpresas llegaron una tras otra.
- AppSync rechazó los resolvers. Los tres resolvers JavaScript fallaron con "The code contains one or more errors." La causa fue una regla de APPSYNC_JS que Node y el lint no detectan. La parte 9 cuenta esa historia.
- La alarma vigilaba una métrica que no existe. La primera ejecución de punta a punta esperaba que la suma de la alarma subiera 1 y leyó "Expected: 1 Received: 0". Una llamada de solo lectura a
list-metricsmostró que AppSync llamaGraphQLErroral conteo de errores por fuente de datos, noErrorscomo decía el diseño. Elegí "A. Use GraphQLError". Primero se cambió la prueba de synth y falló, y luego se corrigió el código. - La corrección no llegó al sandbox. El nuevo despliegue imprimió un error, y aun así el script de despliegue lo registró como hecho. La salida mostró por qué: "HotswapFailed ... is not authorized to perform: cloudformation:UpdateResource". Un sandbox de Amplify siempre despliega con CDK hotswap, que edita una alarma cambiada con mis propias credenciales. Y
ampxsalió con 0 después del fallo, así que el script imprimió PASS. El agente corrigió el script con la prueba primero, así que ahora cualquier línea[ERROR]cuenta como fallo. Para la alarma, elegí "B. Rename the alarm once": un nombre nuevo convierte la edición en un reemplazo, que pasa por un despliegue normal de CloudFormation. - Dos pruebas compartían una dirección. La misma primera ejecución falló el registro con "Sign-up failed: User already exists". El escenario de inicio de sesión y el escenario del esqueleto construían la misma dirección de prueba en una ejecución y en una plataforma. Primero llegó una prueba unitaria que fallaba, y luego la corrección.
En total el sandbox se desplegó seis veces. Cuatro de esos despliegues no lo cambiaron: tres se revirtieron, y uno falló mientras informaba éxito.
El comando de verificación y el checkpoint
Con el backend desplegado, el comando completo pasó: salida 0, con la ejecución de punta a punta tardando 2,9 minutos. Ese no fue el final. AI-DLC ejecuta él mismo el comando aprobado para verificar el checkpoint, y su primera ejecución falló con dos errores nuevos que mi ejecución no había visto.
- Una lectura obsoleta en el lobby. En Firefox el lobby mostró "Last match: place 4 of 4, score 0, Kenya (left)" en lugar de "Last match: place 1 of 4, score 1133, Kenya". Después de un guardado, el lobby pide el último resultado a través de un índice de DynamoDB, y las lecturas de índice son eventualmente consistentes. Justo después del guardado, el índice todavía respondía con la partida anterior y sobrescribía el resultado más nuevo. Era un error real del juego. La corrección llegó con la prueba primero: dos pruebas de gdUnit4, y luego el perfil conserva el resultado que terminó más tarde.
- Un dato tardío en la prueba de la alarma. En Linux la comprobación de la alarma leyó "Expected: 1 Received: 2". La ventana de la prueba empezaba 60 segundos atrás, dentro del minuto de un guardado duplicado anterior cuyo dato llegó tarde. Ahora la ventana empieza en el siguiente minuto completo.
La segunda verificación pasó con verified: true. El informe propio de la ejecución solo conocía los requisitos de inicio de sesión, así que los resultados por requisito y plataforma se construyeron a partir de las etiquetas de los escenarios en el registro de la ejecución:
| Medida | Cantidad |
|---|---|
| IDs de requisitos | 47 |
| Celdas que pasan (requisito × plataforma) | 155 |
| Celdas omitidas | 33 |
| Fallos | 0 |
Las omisiones son intencionadas. Las comprobaciones de la API del almacén de resultados se ejecutan una vez por ejecución, en Linux, y se omiten en Chromium, Firefox y WebKit. Dos objetivos de rendimiento, la tasa de fotogramas y la primera carga, todavía no se miden y siguen listados como huecos.
En el checkpoint AI-DLC preguntó "Anything to add for next time?". Guardé cuatro lecciones como reglas del proyecto: comprobar primero los resolvers de AppSync con EvaluateCode, comprobar el nombre de una métrica antes de diseñar una alarma sobre ella, leer las líneas de error de una herramienta y no solo su código de salida, y esperar que las lecturas de índice vayan con retraso. Luego me pidió aprobar la unidad verificada, y respondí "Approve".
Lo que costó y lo que compró
La construcción del agente desarrollador llevó una hora aproximadamente y 322 llamadas a herramientas. Los despliegues necesitaron seis intentos. El diseño de infraestructura estimó el costo de funcionamiento en un máximo de unos $2,30 al mes para los dos backends, normalmente menos de $0,10, a partir de los precios de lista publicados, porque la herramienta de precios falló en esa sesión.
Lo que compró es una lista de problemas que solo el backend real podía mostrar: la regla de exportación de AppSync, la regex en un resolver, el nombre de la métrica, el límite de hotswap, el script de despliegue que confiaba en un código de salida, la dirección de prueba compartida y la lectura de índice obsoleta. Cada uno se encontró en la primera unidad, en una porción con una tabla y tres resolvers. Ninguno espera a una unidad posterior con partidas en vivo.
Después de la aprobación, AI-DLC preguntó "How should I continue building the remaining work?". Elegí "Continue automatically". Las aprobaciones ordinarias de finalización de las unidades siguientes dejan de llegarme. Las aprobaciones de plan, las confirmaciones de resumen, los fallos y cada visto bueno en AWS siguen llegando.
Lo que sigue
La siguiente unidad es U2, cuentas y perfil. Empieza con su propio functional design.