Automatizar mi pipeline de despliegue con Kiro Workflows
Desde hace tiempo mis proyectos personales corren sobre un único pipeline: un issue de GitHub se convierte en una spec de Kiro, la spec se convierte en una implementación, y cada una aterriza como pull request hacia una rama staging donde una build de preview de Amplify la verifica antes de promover a producción. El proceso está documentado y el estado se mueve solo mediante GitHub Actions. Lo que no estaba, hasta esta semana, era orquestado — seguía dirigiéndolo prompt a prompt: "escribe la spec", luego "ahora revísala", luego "ahora impleméntala", luego "ahora abre el PR".
Kiro lanzó Workflows — un runtime que ejecuta un grafo de pasos de agentes, cada uno en su propia sesión con contexto fresco, con bucles y condiciones de parada. Así que convertí mi pipeline en dos recetas reutilizables. Este artículo es lo que costó, y en concreto los dos bugs que atrapó el validador del runtime y que ninguna lectura del JSON habría encontrado.
Resumen
- Una receta de Workflows es un grafo de nodos
step(mássequence,parallel,repeat,watch), guardado como JSON. Los pasos pasan datos hacia adelante con{{step_id.output}}. - Kiro solo carga archivos de receta llamados
<name>.workflow.json. Un<name>.jsonnormal se ignora en silencio, y el uploader de la nube rechaza una carpeta de ellos. - La condición de parada de un bucle
repeates un objetostopCondition(por ejemplo unfileCheck), no una cadenauntil. El campo equivocado se descarta en silencio — el bucle entonces nunca sale antes de tiempo. - Un paso no puede referenciar el
{{...output}}de un hermano posterior. En la primera iteración esa salida aún no existe; el validador rechaza la referencia hacia adelante. - Las recetas son el director de orquesta; no reemplazan al steering ni a las skills — cada paso igual los carga y puede llamarlos.
La forma de una receta
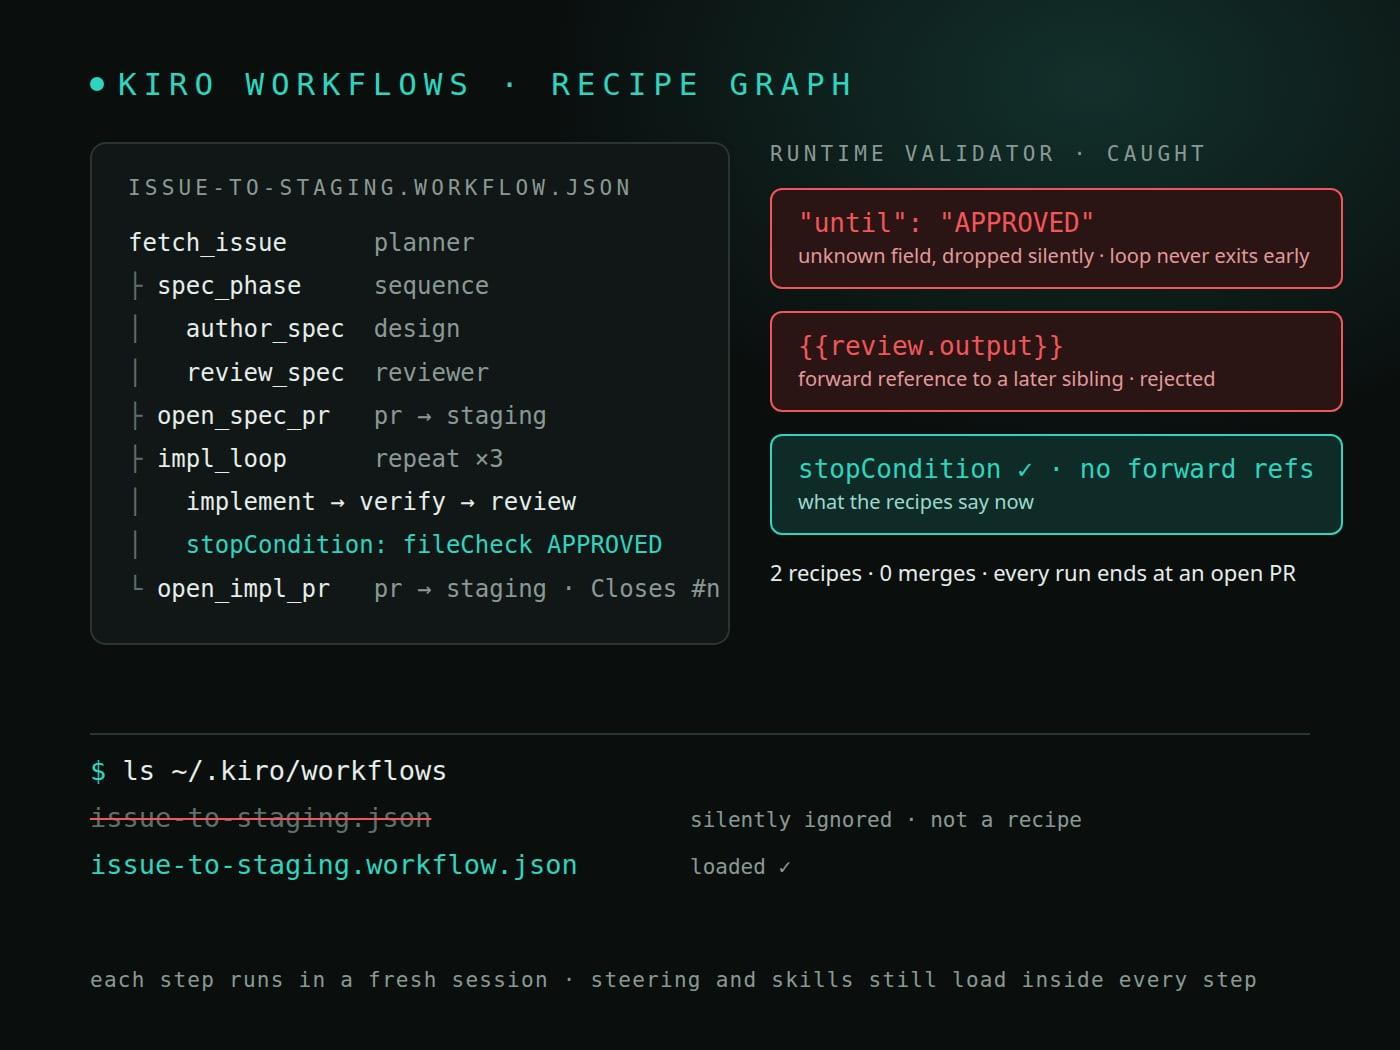
Una receta declara inputs (variables de cadena con nombre) y un árbol de nodos. La que automatiza "issue → PR a staging" se ve así en esquema:
fetch_issue        (planner)   read the GitHub issue, decide new spec vs. amend
  spec_phase       (sequence)
    author_spec    (design)    write requirements / design / tasks
    review_spec    (reviewer)  verdict on the spec
  open_spec_pr     (pr)        branch spec/<n>, PR into staging, Refs #<n>
  impl_loop        (repeat ×3) implement → verify → review, until APPROVED
  open_impl_pr     (pr)        PR into staging, Closes #<n>
Cada paso corre como su propia sesión de agente, así que el revisor juzga el trabajo sin heredar el razonamiento de quien lo codificó. Todo se detiene en un PR abierto — nunca hace merge, porque en mi configuración cada transición de estado depende de un merge humano hacia staging. Esa restricción es el margen de seguridad: lo peor que puede hacer una ejecución es dejar una rama y un PR que puedo cerrar.
El primer muro: el archivo se ignora si no se llama bien
Escribí las recetas, las sincronicé a ~/.kiro/workflows/, e intenté subirlas a la nube para tenerlas disponibles en Kiro Web y en mi otra máquina. El uploader respondió:
No supported configuration files found in the "workflows" folder.
Los archivos eran JSON válido con name y steps. El problema era el nombre del archivo. Hurgando en la extensión instalada apareció la regla que impone: las recetas deben llamarse <name>.workflow.json. Renombrar projects-workflow.json a projects-workflow.workflow.json fue la solución completa. El .json a secas había sido invisible para el runtime todo el tiempo.
La recompensa: valida antes de ejecutar
Con los nombres corregidos, ambas recetas aparecieron en una sesión de Kiro Web. La tentación es ejecutar una de inmediato. Lo mejor es pedirle al runtime que la valide primero — porque el validador conoce reglas que el JSON no puede expresar. Le pedí a Kiro que validara la receta de implementación, y devolvió dos hallazgos.
Bug uno: el bucle no tenía condición de parada real
Mi bucle repeat estaba escrito así:
{
  "type": "repeat",
  "id": "impl_loop",
  "maxIterations": 3,
  "until": "verdict-code.json says APPROVED"
}
until no es un campo del esquema. El runtime lo descartó en silencio, lo que significa que el bucle no tenía condición de parada alguna — correría las tres iteraciones completas siempre, reimplementando dos veces más una funcionalidad ya aprobada. La estructura igual "validaba" porque maxIterations estaba presente; el comportamiento simplemente estaba mal.
El esquema real quiere un stopCondition:
{
  "type": "repeat",
  "id": "impl_loop",
  "maxIterations": 3,
  "onMaxIterations": "pause",
  "stopCondition": {
    "fileCheck": { "path": "verdict-code.json", "jsonPath": "verdict", "value": "APPROVED" }
  }
}
Ahora el bucle sale en cuanto el revisor escribe {"verdict":"APPROVED"} y maxIterations es un tope, no la salida normal.
Bug dos: un paso referenciaba a un hermano que aún no había corrido
Dentro del bucle, el orden es implement → verify → review. Mi prompt de implement intentaba ser listo con las iteraciones posteriores:
On later iterations: address the review findings in {{code_reviews.output}}
El validador lo rechazó: implement referencia {{code_reviews.output}}, pero code_reviews corre después de implement. En la primera pasada esa salida no existe, y la comprobación estática del motor no permite una referencia hacia adelante a un hermano posterior. La intención estaba bien; el mecanismo no.
La solución es dejar de pasar el dato por una variable de plantilla y que el paso lea el artefacto desde disco:
First, check whether a verdict-code.json file exists:
  - absent  -> this is the first iteration; implement from scratch
  - present with CHANGES_REQUESTED -> read its findings and address them
Mismo bucle, misma intención, sin referencia ilegal. Ambas recetas validaron entonces como bien formadas.
Lo que una receta no reemplaza
La confusión que conviene aclarar: una receta no anula ni entra en conflicto con el steering, AGENTS.md o las skills. Opera una capa por encima y las usa.
| Capa | Rol en una ejecución |
|---|---|
Steering / AGENTS.md | Reglas siempre activas que carga la sesión de cada paso — modelo de ramas, convenciones, estándares |
| Skills | Procedimientos invocables que un paso puede llamar (el paso que trae el issue llama al mismo script que envuelve mi skill de spec) |
| Receta | El director — secuencia, bucles, gates, qué agente corre y cuándo |
La precedencia de recetas (proyecto > usuario > cuenta sincronizada > incluidas) solo decide qué receta gana cuando dos comparten nombre. No dice nada sobre steering o skills. El modelo mental que se me quedó: la receta es el director, y el steering y las skills son las instrucciones que los músicos ya conocen.
El hueco que la validación no cierra
La validación demuestra que una receta está bien formada. No demuestra que se ejecute, y una ejecución en la nube tiene prerequisitos que un validador nunca comprueba. Una sesión en la nube es una máquina nueva, y cada paso es una sesión de agente que necesita sus dependencias presentes allí:
- Los scripts no se sincronizan. Configuration Sync tiene categorías para steering, skills, agents, hooks, powers, settings y workflows — pero no
scripts. El primer paso de la receta llama a un script de shell que vive en~/.kiro/scripts/, así que en la nube simplemente no está a menos que el repo objetivo lo lleve. Ese es el fallo más probable en la primera ejecución. - Las credenciales no viajan. La auth de
gh, los permisos de push de git y las credenciales de AWS para el gate de Amplify tienen que existir en el sandbox, no en mi portátil. - La nube ejecuta una instantánea. Kiro Web valida y ejecuta una copia de solo lectura traída por la última sincronización. Editar el archivo local no cambia nada en la nube hasta que vuelves a subirlo — así que tras cada arreglo, re-sincroniza y vuelve a subir.
Así que el estado honesto al final del día: ambas recetas validan, ambas son detectables en la nube, y la ejecución de extremo a extremo contra un repo real es el siguiente paso, no uno terminado. La validación me movió de "probablemente correcto" a "confirmado bien formado", que es justo la distinción que vale la pena pagar antes de confiarle a un bucle que abra pull requests por su cuenta.
La regla que generaliza
- Nombra la configuración declarativa por la convención que impone el runtime, no por lo que lee bien. Un archivo ignorado en silencio te da una lista vacía, no un error.
- Un campo desconocido descartado en silencio es peor que uno rechazado.
untilno falló; simplemente no hizo nada, y el bucle se comportó mal mientras seguía "validando". Prefiere herramientas que rechacen campos desconocidos — y cuando no lo hagan, valida el comportamiento, no solo la estructura. - Las comprobaciones estáticas de grafo prohíben las referencias hacia adelante por una razón. Si un paso necesita el resultado de un paso posterior, eso es un límite de iteración de bucle — persiste el resultado en un archivo y vuelve a leerlo, en vez de apuntar a un nodo que no ha corrido.
- Valida la orquestación antes de ejecutarla. La comprobación barata atrapa el error caro, sobre todo cuando la orquestación puede hacer push de ramas y abrir PRs.