El error del sitemap que no era del sitemap
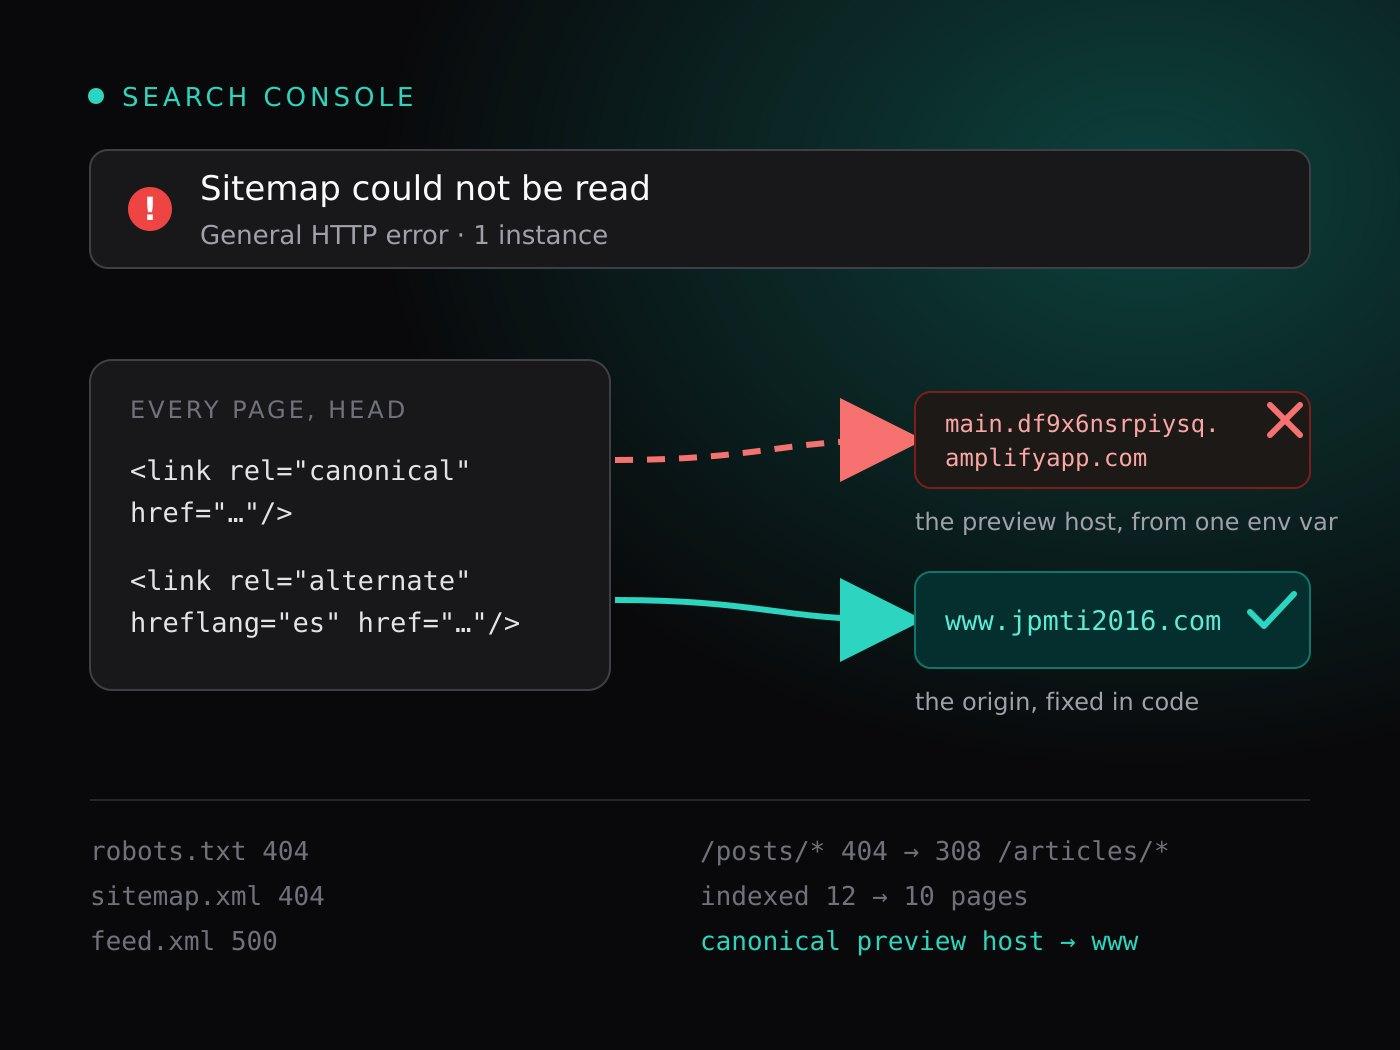
Search Console tenía un único aviso rojo para este sitio: No se ha podido leer el sitemap — Error HTTP general, 1 instancia. Debajo, un conjunto de números más discreto: 17 páginas descubiertas, cuatro URLs antiguas atascadas en "Descubierta: actualmente sin indexar", cuatro 404 y un recuento de páginas indexadas que había bajado de 12 a 10 durante el verano mientras yo seguía publicando.
Di por hecho que el sitemap simplemente no había sobrevivido a una migración entre dos bases de código de Next.js. Y no había sobrevivido. Pero era el cuarto problema más importante, y arreglarlo solo habría dejado intacto el daño real. Este post es la auditoría tal como la hice de verdad — con curl, no con un panel — porque la lección generaliza: Search Console te dice dónde tropezó Google, no por qué. Pregúntale al sitio directamente.
TL;DR
- El error del sitemap era real pero superficial:
/sitemap.xmly/robots.txtno existían y caían en el catch-all de locale, que servía la página 404 con estado 404. - El hallazgo dañino era invisible desde el panel: cada
canonicalyhreflangdel sitio en producción apuntaba amain.<app-id>.amplifyapp.com, porque una variable de entorno de Amplify guardaba la URL del preview. Le estábamos diciendo a Google que las páginas reales eran duplicados de un host al que nadie enlaza. - El feed RSS devolvía 500 porque descargaba y raspaba sus propias páginas en cada petición, algo que expira por timeout en serverless.
- El sitio antiguo vivía en
/posts; el nuevo en/articles; ninguna redirección los unía. Cada enlace antiguo, incluidos los que Google recordaba, era un 404. - Fijar el origen en código, condicionar la indexabilidad a la rama de producción, generar robots/sitemap/feed desde la biblioteca de contenido y convertir la tabla de redirecciones en datos con tests.
El síntoma frente al diagnóstico
Lo primero que hice no fue abrir el informe del sitemap. Fue esto:
for u in /robots.txt /sitemap.xml /feed.xml /posts /posts/free-self-hosted-web-analytics; do
  curl -sS -o /dev/null -w "$u %{http_code} %{content_type}\n" "https://www.jpmti2016.com$u"
done
/robots.txt 404 text/html; charset=utf-8
/sitemap.xml 404 text/html; charset=utf-8
/feed.xml 500
/posts 404 text/html; charset=utf-8
/posts/free-self-hosted-web-analytics 404 text/html; charset=utf-8
Cuatro líneas, cuatro problemas, ninguno el que esperaba estar arreglando. Después miré lo que ve un rastreador en el <head> de la portada:
curl -s https://www.jpmti2016.com/ | grep -o '<link rel="canonical"[^>]*>\|<link rel="alternate"[^>]*>'
<link rel="canonical" href="https://main.df9x6nsrpiysq.amplifyapp.com"/>
<link rel="alternate" hrefLang="en" href="https://main.df9x6nsrpiysq.amplifyapp.com"/>
<link rel="alternate" hrefLang="es" href="https://main.df9x6nsrpiysq.amplifyapp.com/es"/>
<link rel="alternate" hrefLang="x-default" href="https://main.df9x6nsrpiysq.amplifyapp.com"/>
<link rel="alternate" type="application/rss+xml" href="https://main.df9x6nsrpiysq.amplifyapp.com//feed.xml"/>
Ese es el hallazgo que importaba. Una etiqueta canonical es una página diciendo "la copia autorizada de mí vive allí". Cada página de www.jpmti2016.com señalaba allí — al dominio por defecto de Amplify para la rama main. La deduplicación de Google hace exactamente lo que se le indica: consolida las señales en el canonical declarado y saca el duplicado del índice. El descenso lento de 12 páginas indexadas a 10 no era un problema de contenido. Era el sitio votando contra sí mismo en cada URL.
La doble barra en el enlace del feed delataba la causa: una variable de entorno con barra final.
Cómo una variable de entorno mintió a todas las páginas
La plantilla del sitio lee su origen público de NEXT_PUBLIC_SITE_URL y lo usa como metadataBase de Next, que es lo que convierte las rutas relativas de canonical y hreflang en URLs absolutas. En local esa variable está en .env.local. En Amplify Hosting se define por app, y en algún momento el valor pasó a ser la URL del preview, probablemente al comprobar el primer despliegue, y nadie volvió a mirarlo.
La solución no fue corregir el valor. Fue dejar de confiar en un valor. Un sitio tiene exactamente un origen público; su sitio es el código:
// src/lib/site.js
export const SITE_URL = 'https://www.jpmti2016.com'

/**
 * True only for the build that serves the public domain. Amplify sets
 * AWS_BRANCH on every build; SITE_ENV=production lets a local build be
 * checked with the same behavior. Everything else is a preview and
 * must never be indexed.
 */
export function isProduction(env = process.env) {
  return env.AWS_BRANCH === 'main' || env.SITE_ENV === 'production'
}
Cada URL de canonical, hreflang, sitemap, feed y datos estructurados deriva ahora de SITE_URL, sea cual sea la rama que renderizó la página. Y el segundo export es lo que impide que esta clase de error vuelva con otra forma: el preview de staging también renderiza URLs absolutas al dominio de producción, y se declara no indexable.
// src/app/[locale]/layout.jsx — generateMetadata()
metadataBase: new URL(SITE_URL),
robots: isProduction()
  ? { index: true, follow: true }
  : { index: false, follow: false },
// src/lib/robots.js
export function robotsRules({ production }) {
  if (!production) {
    return { rules: { userAgent: '*', disallow: '/' } }
  }
  return {
    rules: [{ userAgent: '*', allow: '/', disallow: ['/api/', '/thank-you'] }],
    sitemap: `${SITE_URL}/sitemap.xml`,
  }
}
Un host de preview sigue siendo accesible, pero ahora dice noindex en cada página y Disallow: / en su archivo robots, mientras sus canonicals apuntan a casa. Esa es la postura correcta para cualquier entorno que no sea producción, y cuesta un booleano.
Lo que la migración dejó atrás
El sitio anterior era una app con Pages Router. Escribía public/sitemap.xml desde un script enganchado a la compilación de webpack, servía un public/robots.txt escrito a mano y publicaba el blog en /posts y /es/posts. El nuevo sitio con App Router conservó el contenido y el diseño y perdió las tres cosas sin hacer ruido, porque ninguna era contenido — eran fontanería, y la fontanería no se migra sola.
Las rutas de metadatos de Next sustituyen al script. src/app/sitemap.js y src/app/robots.js son finas; la lógica vive en módulos puros que reciben el contenido ya cargado y tienen tests unitarios sin tocar MDX:
// src/app/sitemap.js
export default async function sitemap() {
  const articles = []
  const projects = []
  for (const locale of LOCALES) {
    articles.push(...(await getAllArticles(locale)))
    projects.push(...(await getAllProjects(locale)))
  }
  return buildSitemap({ articles, projects })
}
buildSitemap emite una entrada por URL y por locale, con alternates.languages para que Google vea en el sitemap los mismos pares hreflang que las páginas declaran en su head. Setenta y dos URLs, y la página de agradecimiento tras suscribirse deliberadamente ausente.
Las URLs antiguas pasaron a ser datos en lugar de configuración, para que el mapeo sea algo que un test pueda leer:
// src/lib/redirects.mjs
export const legacyRedirects = [
  { source: '/posts', destination: '/articles', permanent: true },
  { source: '/posts/:slug', destination: '/articles/:slug', permanent: true },
  { source: '/es/posts', destination: '/es/articles', permanent: true },
  { source: '/es/posts/:slug', destination: '/es/articles/:slug', permanent: true },
  // …
]
La verificación de esa tabla fue la propia exportación de Search Console. Cada URL que Google había marcado, seguida hasta el final:
for p in /posts /es/posts /posts/6-free-resources-to-learn-Rust /posts/async-update-related-items; do
  curl -s -L -o /dev/null -w "$p -> %{http_code} %{url_effective}\n" "http://localhost:3100$p"
done
/posts -> 200 http://localhost:3100/articles
/es/posts -> 200 http://localhost:3100/es/articles
/posts/6-free-resources-to-learn-Rust -> 200 http://localhost:3100/articles/6-free-resources-to-learn-Rust
/posts/async-update-related-items -> 200 http://localhost:3100/articles/async-update-related-items
Si Google lo marcó y ahora aterriza en un 200, esa marca se limpiará sola. El único que queda como 404 es /utils/gtag, la URL de un módulo JavaScript del sitio antiguo que nunca fue una página. Un 404 es la respuesta correcta para él.
El feed que se raspaba a sí mismo
La ruta /feed.xml de la plantilla funcionaba así: para cada artículo, fetch() del HTML del propio artículo por HTTP, cargarlo en cheerio, extraer título, fecha y cuerpo del DOM y añadir el elemento. Diecinueve artículos, diecinueve renderizados del lado del servidor, en secuencia, dentro de una sola petición. En un portátil tarda unos segundos. En el cómputo de Amplify alcanza el timeout de la función, y CloudFront lo reporta como un 500 vacío.
El reemplazo es aburrido, que es la idea. Los metadatos del artículo ya se exportan desde cada archivo MDX, así que el feed los lee directamente y se genera una sola vez en tiempo de compilación:
// src/app/feed.xml/route.js
export const dynamic = 'force-static'

export async function GET() {
  const feed = new Feed({ title: SITE_NAME, id: SITE_URL, link: SITE_URL, language: 'en' })
  for (const article of await getAllArticles('en')) {
    const url = absoluteUrl('en', `/articles/${article.slug}`)
    feed.addItem({
      title: article.title,
      id: url,
      link: url,
      description: article.description,
      date: new Date(`${article.date}T00:00:00Z`),
    })
  }
  return new Response(feed.rss2(), { headers: { 'content-type': 'application/xml; charset=utf-8' } })
}
Los elementos llevan la descripción en lugar del cuerpo completo. Ningún lector de feeds lo ha echado en falta.
Tres trampas de Next.js con las que tropecé por el camino
Ninguna es un bug. Todas están documentadas. Todas me costaron una recompilación.
Los alternates del layout se reemplazan, no se fusionan. El layout de locale declaraba el enlace RSS en alternates.types, y cada página declaraba sus propios alternates para canonical y hreflang. Next fusiona los metadatos de forma superficial por clave de primer nivel, así que el objeto de la página reemplazaba el alternates completo del layout — y el enlace RSS faltaba en cada página que tenía un canonical, es decir, en todas. La entrada RSS viaja ahora dentro del mismo helper que construye el canonical.
La convención de archivo opengraph-image rellena los segmentos dinámicos de forma literal. Con el locale por defecto del sitio sin prefijo (/about, no /en/about), un opengraph-image.jsx dentro de app/[locale]/ produce URLs de og:image con la forma /en/opengraph-image, y la redirección de /en/* las rebota. Funcional, pero descuidado para algo que un rastreador descarga. Las tarjetas pasaron a ser route handlers normales, con la URL construida explícitamente.
El middleware de locale ignora cualquier ruta con un punto. El matcher que mantiene feed.xml y favicon.ico fuera de la negociación de idioma es el razonable '/((?!api|_next|_vercel|.*\\..*).*)'. Eso significa que una ruta en app/[locale]/og.png/route.js funciona en /es/og.png, donde el locale está en la URL, y devuelve 404 en /og.png, porque nada la reescribe a /en/og.png. La ruta es ahora /og — sin extensión, y la cabecera content-type se encarga del resto.
/og                                                200 image/png
/es/og                                             200 image/png
/articles/deploying-nextjs16-on-amplify-ssr/og     200 image/png
/articles/no-such-post/og                          404
Lo que reciben los rastreadores de IA
El archivo robots antiguo bloqueaba GPTBot, CCBot y Google-Extended, lo que en 2022 se leía como prudencia. Para un sitio cuyo único propósito es que lo encuentren y lo citen cuando alguien se topa con el mismo error que yo, ahora se lee como autosabotaje. El nuevo archivo permite explícitamente los rastreadores de los motores de respuesta — los de OpenAI, Anthropic, Perplexity, el rastreador extendido de Google, el de Apple — y la regla * permite a todos los demás. Nombrarlos no cambia nada mecánicamente; hace la política legible en el archivo servido.
Dos pequeñas adiciones encima. Un llms.txt en la raíz, generado desde la misma biblioteca de contenido que el sitemap, le da a un asistente un índice en Markdown con una línea por artículo y su descripción, para que una respuesta pueda citar la URL correcta en lugar de la portada. Y el JSON-LD entró donde Google lo documenta: Person y WebSite en la portada, BlogPosting más BreadcrumbList en cada artículo, con los perfiles del autor como sameAs. Cada valor de esos objetos es algo que la página ya dice; los datos estructurados son una reformulación, no un lugar donde hacer afirmaciones.
La trampa de Amplify justo al final
Con todo desplegado, quedaba un cabo suelto: el host por defecto main.<app-id>.amplifyapp.com seguía sirviendo una copia indexable del sitio. Sus canonicals ya apuntaban a casa, así que Google consolidaría correctamente, pero una redirección es más limpia. Añadí una regla en las reescrituras y redirecciones de Amplify con el origen https://main.<app-id>.amplifyapp.com/<*>, destino https://www.jpmti2016.com/<*>, tipo 301.
No pasó nada. Ni error, ni redirección. La documentación explica por qué, en un recuadro "Important" que es fácil pasar por alto:
Path components in domain-based source rules (such as
"https://domain.com/path") are not supported and will cause the rule to be ignored without error.
Una regla basada en dominio toma el origen desnudo como fuente, y Amplify añade la ruta por su cuenta. Quita el comodín de ambos lados y funciona en la siguiente petición:
curl -sS -o /dev/null -w "%{http_code} -> %{redirect_url}\n" "https://main.df9x6nsrpiysq.amplifyapp.com/about"
301 -> https://www.jpmti2016.com/about
La misma página de la consola tenía otra cosa que merecía un toque: la regla autogenerada de Amplify de apex a www usa 302 por defecto. Search Console la lista bajo "Página con redirección" para siempre. Es un desplegable; ponlo en 301.
Reglas que generalizan
- Audita con
curl, no con el panel. Search Console informa de lo que Google no pudo hacer. Descargar tú mismo las mismas URLs te dice por qué, en segundos, y saca a la luz los problemas que Google aún no ha reportado. - El origen público es código, no configuración. Un sitio tiene uno. Ponlo en un módulo, deriva de él cada URL absoluta y condiciona la indexabilidad a la rama que lo sirve. Los previews reciben
noindexy canonicals que apuntan a casa. - La fontanería no se migra sola. Cuando un sitio cambia de framework, enumera lo que la compilación antigua generaba — sitemap, robots, feed, redirecciones, cabeceras — y comprueba cada elemento contra el nuevo despliegue con una petición, no con un vistazo al repositorio.
- Demuestra las redirecciones contra la exportación. La lista de URLs en las que Google está atascado es el fixture del test. Sigue cada una hasta el final y exige un 200.
- Lee el recuadro "Important". Dos veces.
Referencias
- Google Search Central: consolidar URLs duplicadas con canonicals
- Google Search Central: versiones localizadas de tus páginas (hreflang)
- Next.js:
generateMetadatay cómo se fusionan los metadatos - Next.js: ruta de metadatos
sitemap.js - Next.js: ruta de metadatos
robots.js - AWS Amplify Hosting: referencia de ejemplos de redirecciones y reescrituras
- Propuesta llms.txt