Aprender AI-DLC creando un juego, parte 11: retrospectiva
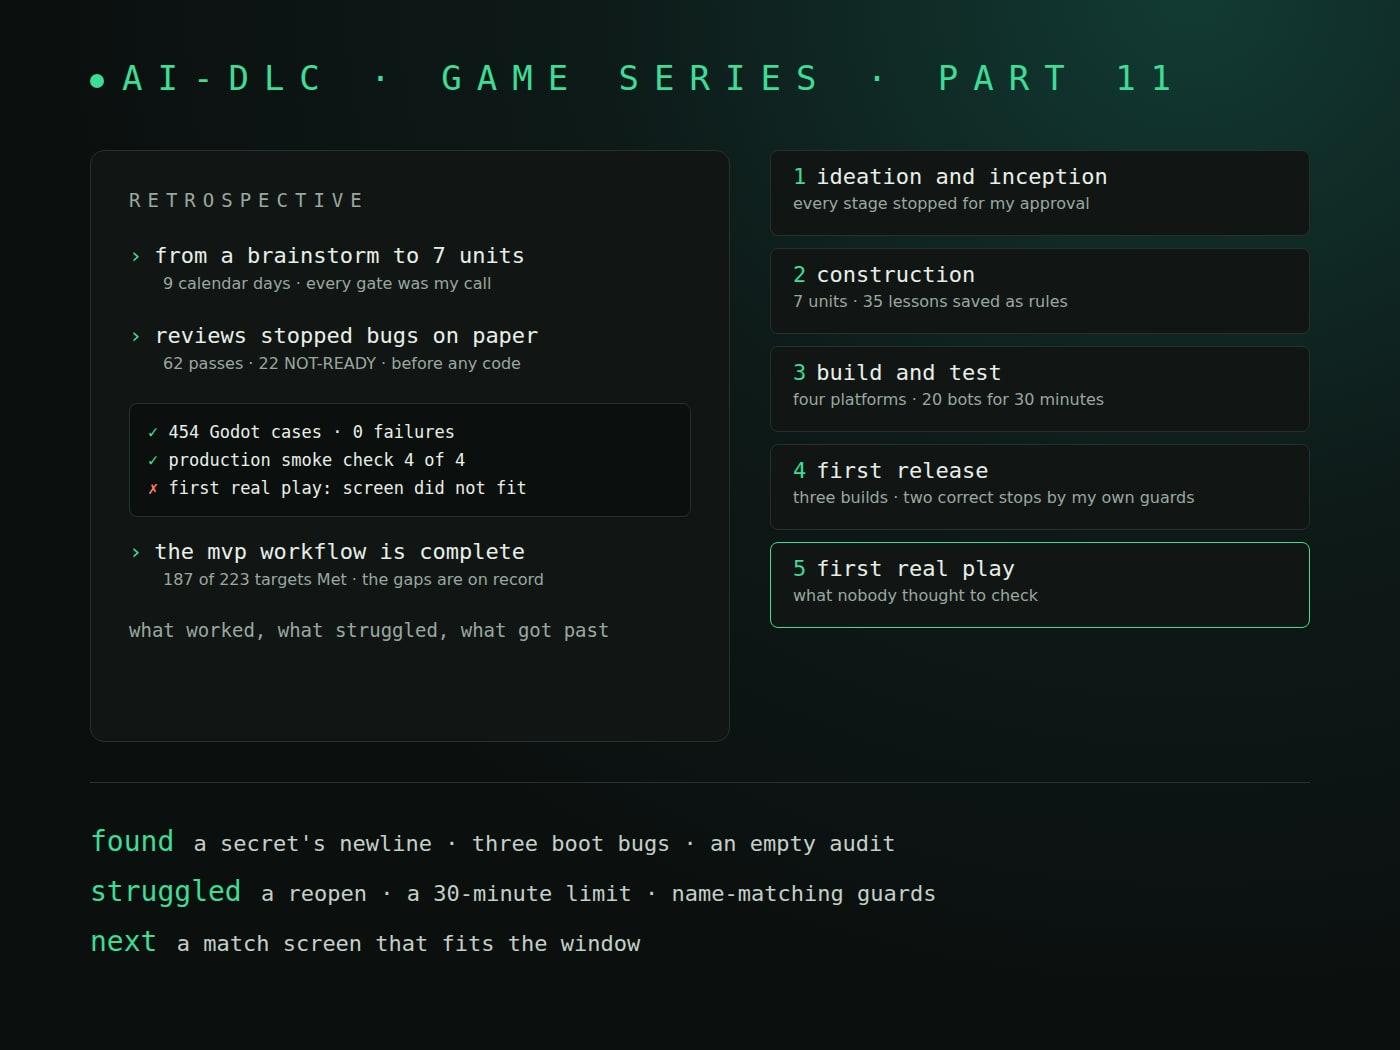
Esta es la parte 11 de una serie sobre aprender AI-DLC creando un juego, World Rift Conflict, en Godot con un backend en AWS. La parte 1 lo configuró, y la parte 10 construyó la primera unidad. El workflow mvp ya está completo, así que este artículo repasa la ejecución entera.
Partes hasta ahora:
- Parte 1: configuración
- Parte 2: prueba de concepto
- Parte 3: pruebas E2E automatizadas
- Parte 4: lo que hallaron las revisiones
- Parte 5: dentro de una etapa
- Parte 6: un bugfix
- Parte 7: ideación
- Parte 8: incepción
- Parte 9: un error de AppSync
- Parte 10: esqueleto funcional
- Parte 11: retrospectiva (este artículo)
TL;DR
- Un solo workflow de AI-DLC llevó el juego de una lluvia de ideas a siete unidades construidas y probadas en nueve días naturales, y yo decidí en cada puerta de aprobación.
- Las puertas de aprobación y las revisiones adversariales valieron su costo: las revisiones frenaron bugs reales de diseño antes de que existiera código.
- El framework tuvo problemas con una unidad reabierta que nunca volvió a enrutarse, un límite fijo de 30 minutos en las comprobaciones, guards que reaccionan a nombres de archivo y trabajo demasiado grande para un solo agente.
- El backend real y Stripe aún encontraron defectos que todas las pruebas locales y revisiones habían dejado pasar.
- El primer lanzamiento a producción necesitó tres builds. Dos los detuvieron controles que yo mismo había añadido, y ambas paradas eran correctas. Después, la comprobación de humo de producción pasó 4 de 4.
- Luego jugué. La pantalla de partida no cabía en la ventana del navegador, y ninguna comprobación había preguntado si cabría.
Lo que me propuse construir
El juego es una partida corta de estrategia entre países. Cada jugador recibe un país con estadísticas tomadas de datos públicos, juega unas pocas rondas, enfrenta eventos y gana la mejor puntuación. La primera versión necesitaba partidas contra países controlados por el ordenador, inicio de sesión y resultados guardados, eventos con datos del mundo real, partidas en línea en vivo para 2 a 4 jugadores, descargas de escritorio y herramientas de propietario para mantener el costo mensual por debajo de unos $50. Un checkout para apoyar el juego está construido pero apagado.
El proceso importaba tanto como el juego. Quería ver qué hace AI-DLC en un proyecto más grande que una demo: un intent, Ideation, Inception y luego Construction unidad por unidad, con una puerta de aprobación entre pasos y un registro escrito de cada decisión.
La ejecución en números
Los conteos salen de aidlc engine runtime summary --json, de los propios registros de AI-DLC y de mi bitácora.
| Medida | Valor |
|---|---|
| Días naturales | 9 (2026-10-29 a 2026-11-06) |
| Etapas ejecutadas | 20, más 3 etapas de preparación |
| Unidades de trabajo | 7 |
| Respuestas registradas en archivos de preguntas | 254, en 48 archivos |
| Pasadas de revisión | 62: 40 READY, 22 NOT-READY |
| Disparos de sensores | 166, de ellos 47 fallidos |
| Lecciones capturadas | 35 |
| Loop-backs | 1 |
| Casos de prueba de Godot | 454, 0 fallos |
| Cobertura de GDScript | 87,1% de las líneas de sentencias (3818 de 4385) |
| Objetivos de requisitos comprobados al final | 223: 187 Met, 1 Not Met, 34 Unverified, 1 N/A |
La parte de TypeScript tiene sus propias suites. Al final de la última unidad, test:unit pasó 213 de 213, test:backend 151 de 151, test:owner 82 de 82, test:infra 88 de 88, y test:live 95 con 2 omitidas. La suite de extremo a extremo corre en cuatro plataformas: el build de Linux y el build web en Chromium, Firefox y WebKit. Sus ejecuciones finales tuvieron 0 fallos en todas las plataformas.
La prueba de carga de las partidas en vivo corrió 20 bots durante 30 minutos en un host temporal: 134 resultados de ronda, un máximo de 439 ms, p99 de 216 ms y 0 errores.
Lo que AI-DLC hizo bien
Las puertas me mantuvieron al mando. Cada etapa de Ideation e Inception se detuvo a esperar mi aprobación antes de que empezara la siguiente. Code Generation me mostró un plan y esperó "Approve Plan" antes de escribir código. Cada ronda de preguntas terminó con un resumen que yo tenía que confirmar. Cuando no estuve de acuerdo con una recomendación, ganó mi respuesta. Para el checkout de apoyo, el agente recomendó un merchant of record y yo elegí Stripe Checkout. Después del esqueleto funcional elegí "Continue automatically", y las aprobaciones rutinarias dejaron de llegarme. Las aprobaciones de plan, los fallos y cada acción en AWS siguieron llegando.
Las revisiones adversariales encontraron bugs reales en papel. Un agente revisor aparte leyó la salida de cada etapa y podía responder NOT-READY. Lo hizo 22 veces. Algunos ejemplos, solo de las etapas de diseño de la unidad de herramientas de propietario:
- una partida en vivo con 3 humanos habría contado como 3 partidas terminadas;
- un checkout completado después de borrar la cuenta habría dejado una suscripción de pago que nadie cancela;
- el diseño limitaba los roles por un prefijo de clave que IAM no puede usar para limitar.
Antes, un revisor demostró solo razonando que el modelo de puntuación de la primera unidad hacía imposible la comprobación de equilibrio. Nada de esto necesitó una prueba para encontrarse. Se corrigió en un archivo de diseño, antes de cualquier código.
Las lecciones se volvieron reglas. En cada puerta AI-DLC preguntó "Anything to add for next time?". Las respuestas fueron a project.md como reglas que toda etapa posterior lee. Algunas salieron del dolor: comprobar los resolvers de AppSync con evaluate-code antes del primer despliegue, leer las líneas de error de una herramienta de despliegue y no solo su código de salida, recortar los secretos al leerlos, desplegar desde cero cada host antes de su checkpoint y auditar lo que se publica.
El registro está completo. Cada pregunta, respuesta, revisión y decisión está en archivos que puedo citar. Esta serie se escribe a partir de ellos.
Dónde le costó
Una reapertura que nunca volvió. Durante Build and Test descubrí que un criterio de aceptación, AC2.5.3 ("a former player"), se había pasado de una unidad a otra y nunca se construyó. AI-DLC me dejó reabrir la unidad y registró el rechazo, pero next siguió enrutando a Build and Test. aidlc doctor informó "0 problems, 5 warnings", y ninguno lo explicaba. Lo acepté como una brecha conocida, para construirla en un seguimiento antes del lanzamiento. El archivo de estado todavía muestra Code Generation en curso.
Un límite fijo de 30 minutos en las comprobaciones del checkpoint. AI-DLC detiene el comando de verificación de un checkpoint después de 30 minutos. La primera vez que lo alcancé, el comando fue terminado y dejó su ejecutor de pruebas huérfano, todavía corriendo una hora después. La suite de cuatro plataformas había crecido más allá de ese límite, así que la dividí: Linux y Chromium dentro de la comprobación, Firefox y WebKit como una ejecución registrada aparte antes de cada checkpoint. La comprobación de la última unidad terminó en 27,3 minutos, otra vez cerca del límite.
Guards que reaccionan a nombres. Un guard de AI-DLC protege el registro de auditoría. Rechazó que el agente ejecutara el script de pre-push, porque un archivo de log nuevo se llamaba pre-push-check-audit.log y "audit" coincidía con la regla. Mis propios push no se ven afectados, y el cambio de nombre sigue pendiente. Antes, el guard del plan rechazó todos los comandos de shell, incluso cat y grep, hasta que existió el archivo del plan.
Trabajo demasiado grande para un agente. La construcción de las herramientas de propietario tenía 45 tareas. El primer agente desarrollador se detuvo por un límite de crédito de la API ("Credit balance is too low"). Reanudado, se detuvo otra vez en la tarea 29 para no salirse de su contexto. Un agente nuevo, con un traspaso por escrito, terminó el resto. Reanudar también tenía su costo: una reanudación entregó las reglas de la etapa en tres partes antes de empezar ningún trabajo.
Las reglas se leen, no se imponen. La regla de evaluate-code ya existía cuando se desplegaron los resolvers de la última unidad, y aun así el despliegue se hizo primero. Esa vez no se rompió nada, pero una regla en un archivo solo ayuda cuando alguien la sigue.
Lo que solo el entorno real detectó
Cada uno de estos pasó las pruebas unitarias, las de escena y al menos una revisión.
- Un secreto con salto de línea. El checkout de apoyo falló en las cuatro plataformas con "Support is not available right now". El secreto de Stripe se había guardado con un salto de línea al final, porque la configuración pasaba
value + "\n", y el código lo leía sin recortar. Esto causó el único loop-back de la ejecución: se reabrió Code Generation de esa unidad, la corrección recibió pruebas de regresión y la revisión volvió READY. - Las páginas alojadas de Stripe y los navegadores automatizados. Stripe mostró una comprobación hCaptcha a los navegadores de prueba, y "Subscribe" se quedó en "Processing" durante 3 minutos. Elegí pagar a través de la API de prueba de Stripe. El escenario aún comprueba que las páginas reales de checkout y facturación se abren con el producto y el precio correctos.
- Tres bugs de arranque en el host en vivo. El primer despliegue desde cero del servidor de partidas en vivo nunca arrancó. La espera de red trataba el 403 de la dirección de prueba como "sin red". La carpeta de logs era
0700de root, así que el proxy se cerraba. Y la comprobación "¿soy el programa principal?" del servidor fallaba cuando se iniciaba a través de un enlace simbólico. Cada corrección recibió una prueba de regresión que primero falló. - Una auditoría que no comprobaba nada.
npm audit --omit=deven la raíz pasaba, pero todos los paquetes de la raíz son devDependencies, así que no auditaba nada. El nuevocheck:auditaudita los 42 paquetes que importa el código de ejecución: 0 avisos.
El patrón de la parte 10 se mantuvo hasta el final. Las revisiones detectan lo que se puede razonar. Los despliegues detectan lo que hace la plataforma.
El lanzamiento
Hacer push de main despliega producción, y ese paso es mío, no del agente. El push llevó unos 80 commits: el juego entero. Necesitó tres builds.
- El build 1 se detuvo en la nueva comprobación de alertas de gasto: el rol de build de Amplify no podía listar el tema de alertas. No se desplegó nada y producción mantuvo su versión anterior. Es la comprobación haciendo su trabajo. Añadí al rol una pequeña política de solo lectura.
- Antes del siguiente build tenían que existir los valores provisionales de Stripe en producción. El comando que los escribe falló con el código 252, porque esta versión de la AWS CLI no puede leer
--cli-input-json file:///dev/stdin. Las pruebas unitarias usaban una CLI simulada y nunca lo vieron. La corrección escribe la entrada en un archivo temporal privado, con una prueba de regresión. - El build 2 superó los permisos de lectura y se detuvo en el presupuesto: AWS tenía cinco alertas y la comprobación esperaba exactamente cuatro. Alguien, casi seguro yo, había añadido en la consola una alerta de "gasto real por encima de 50 $". Decidí aceptar alertas de más, porque una alerta extra solo puede avisar más.
- El build 3 salió bien. La comprobación de humo de producción pasó primero 3 de 4, porque mi propio rol no podía leer la tabla de producción: los despliegues de rama nombran sus tablas con el ID de la app, no con su nombre. Un patrón de recurso más y pasó 4 de 4: el juego carga y arranca, la página de descargas carga, el host en vivo está sano con su alarma activa y el pago de apoyo está desactivado.
Cada una de estas paradas fue un control que yo había pedido, fallando de forma segura ante un hueco real. Ese es el resultado que se busca de una puerta. Aun así, costó una tarde.
Lo que halló la primera partida real
La comprobación de humo demuestra que el juego carga y arranca. Luego jugué por primera vez al build web de producción, y la pantalla de partida no cabía en la ventana del navegador. Los controles deslizantes y las filas de propuestas quedaban cortados por la izquierda, la lista de jugadores por la derecha y los botones de la barra superior por arriba. Las explicaciones largas ocupaban la pantalla principal, la zona de propuestas repetía los mismos tres botones para cada país y no había ni banner, ni mapa, ni banderas.
Todas las suites estaban en verde, porque ninguna preguntaba si un control cabía dentro de la ventana. Esa pregunta ya tiene su propio trabajo, separado del workflow mvp terminado: un diseño que quepa, etiquetas cortas con ayuda a petición y elementos visuales. Está en curso y aún no se ha publicado.
Las revisiones detectan lo que se puede razonar, y los despliegues detectan lo que hace la plataforma. Una persona jugando detecta lo que a nadie se le ocurrió comprobar.
Lo que sigue
Primero viene el trabajo de la interfaz. Después, AC2.5.3; luego, los objetivos que necesitan un mes de datos (seguimientos con fecha 2026-12-05) y el único objetivo Not Met (NFR3.5, porque Amplify añade AWS_IAM). Luego, el acceso de producción a SES para los correos de registro, los builds de Windows y macOS, y algunos puntos abiertos del juego, como que los países fuertes en lo militar quedan rezagados en el equilibrio. El pago de apoyo sigue desactivado hasta conocer los costes de funcionamiento.