Anthropic AI SDLC vs AWS AI-DLC vs Cursor pstack vs mi workflow
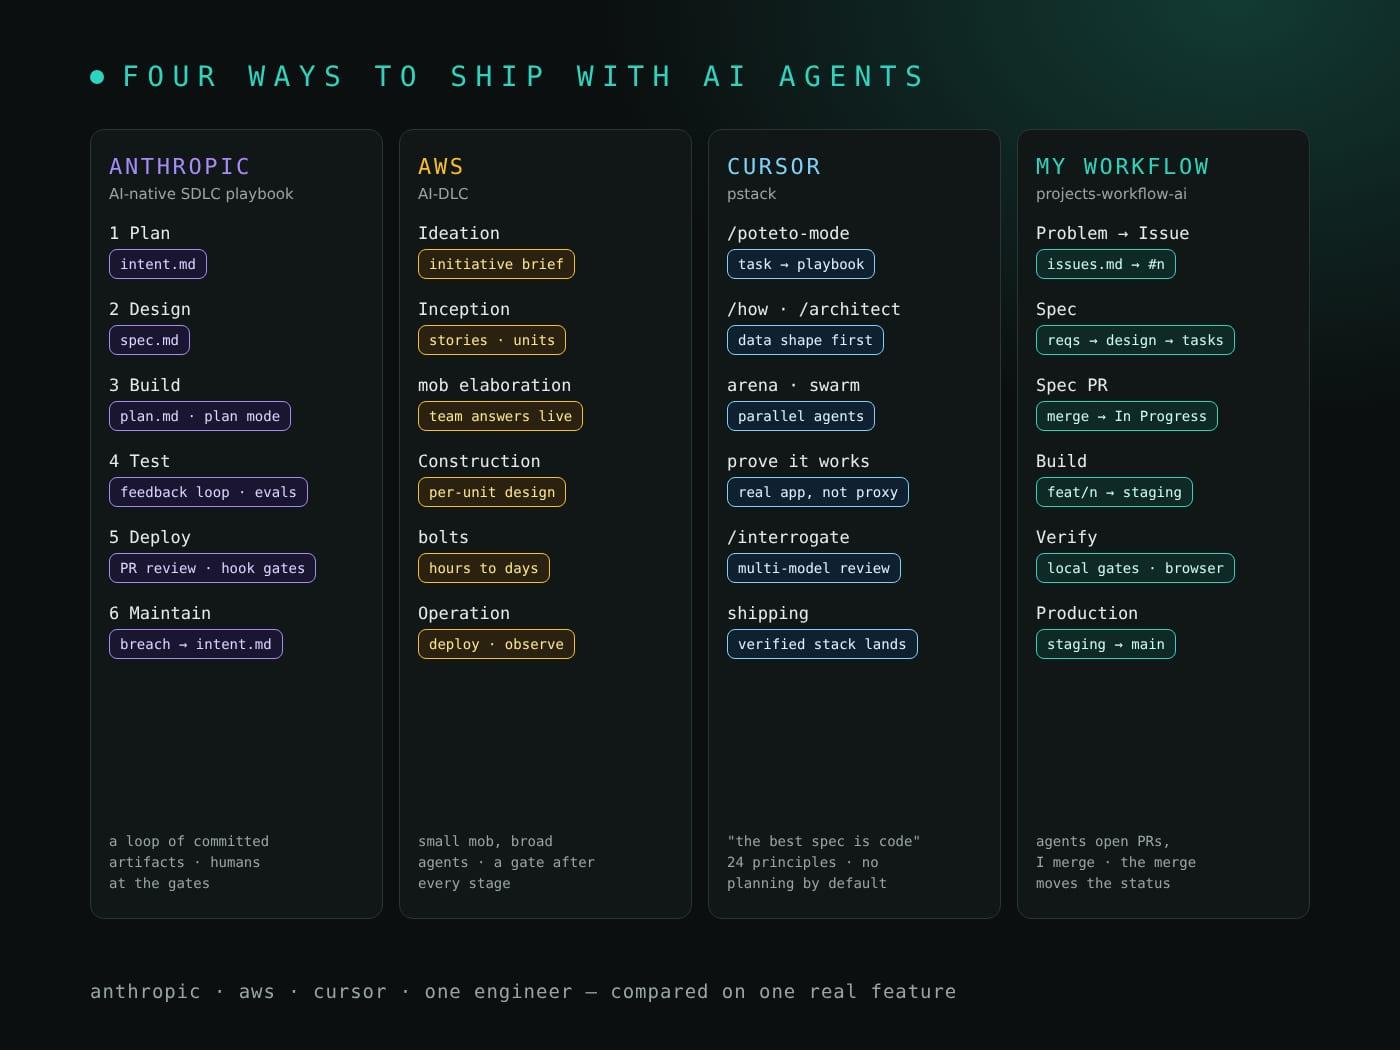
Hoy existen cuatro respuestas serias a la pregunta que yo me respondo en cada proyecto personal: ¿cómo se construye software cuando un agente de IA escribe la mayor parte del código? Anthropic publicó The AI-native SDLC playbook como curso de Anthropic Academy. AWS publicó el método AI-Driven Development Lifecycle (AI-DLC) y una implementación open source. Cursor publicó pstack, las skills que poteto — miembro del equipo core de React que ha trabajado en Meta, Netflix y Cursor — usa a diario para entregar allí. Y yo tengo el mío, projects-workflow-ai, el pipeline detrás de cómo entrego software.
Quería saber dónde coincide el mío con los otros tres, dónde se queda corto y dónde es más simple a propósito. Así que este artículo alinea los cuatro etapa por etapa, asigna las funciones de Claude Code y Kiro que encajan en cada paso, y luego pasa una feature real por los cuatro.
Resumen
- Anthropic, AWS y yo reemplazamos el SDLC lineal por un bucle de artefactos escritos: cada etapa escribe un archivo en el repositorio y la siguiente empieza leyéndolo. La atención humana se concentra en las puertas entre ellas.
- pstack de Cursor es la voz disidente. No es un ciclo de vida sino un motor de rigor: un único punto de entrada,
/poteto-mode, lleva cada tarea a uno de 23 playbooks y aplica 24 principios de ingeniería. No incluye skills de planificación a propósito — "la mejor spec es el código" — y dedica su esfuerzo a explorar el diseño, a la revisión con varios modelos y a probar que el cambio funciona en la app real. - El playbook AI-native SDLC de Anthropic tiene seis etapas — planificar, diseñar, construir, probar, desplegar, mantener — escritas para una organización de ingeniería con product owners, code owners y un equipo de plataforma. Sus movimientos característicos son
intent.md, plan mode, hooks como puertas de aprobación y evals en CI. - AI-DLC de AWS organiza el trabajo en fases — Inception, Construction y Operation, con Ideation delante en la implementación actual — alrededor de un mob: un equipo pequeño que valida en vivo las preguntas y propuestas de la IA. El trabajo se corta en unidades y se entrega en bolts de horas a días.
- Mi workflow es la versión en solitario del bucle de artefactos: issue → spec con puertas al estilo Kiro → implementación en una rama →
staging→main. Los agentes abren pull requests; yo los fusiono. De los otros tres tomo un paso de plan, evals para mis skills, una señal de producción y el verificador independiente de pstack.
Los cuatro, en un párrafo cada uno
Anthropic: el playbook AI-native SDLC. El curso de Anthropic (14 lecciones cortas, con un artículo complementario extenso) parte de una observación: cuando el código deja de ser el cuello de botella, el cuello de botella se mueve a las etapas a ambos lados de la construcción — planificación, revisión y despliegue — que siguen corriendo a velocidad humana. Su respuesta es un conjunto de "plays" modulares, cada uno terminado en un artefacto versionado: intent.md, spec.md, plan.md, el diff con sus tests, el PR revisado y el registro del incidente. Un artefacto aceptado dispara la siguiente puerta, y una banda de control superada en producción escribe el siguiente intent.md.
AWS: AI-DLC. El documento del método de AWS (Raja SP, 2025) plantea el ciclo en tres fases. En Inception, la IA convierte la intención de negocio en requisitos, historias y unidades mediante mob elaboration. En Construction, la IA propone la arquitectura, el modelo de dominio, el código y los tests mediante mob construction. En Operation, la IA aplica el contexto acumulado a la infraestructura y los despliegues con supervisión del equipo. El repositorio open source awslabs/aidlc-workflows lo convierte en un harness instalable, /aidlc, que corre en Claude Code, Kiro y otros agentes: cinco fases, 33 etapas, un motor determinista, una puerta de aprobación después de cada etapa y un registro de auditoría de cada decisión. Su filosofía es "small mob, broad agents".
Cursor: pstack. pstack es un plugin de skills, no un documento de proceso. El objetivo de su autor es lo contrario de producir más: "pstack te ayuda a escribir menos código, pero de mayor calidad", y ese rigor es lo que hace seguro ejecutar muchos agentes en paralelo. Escribes /poteto-mode con un objetivo y una forma de comprobarlo; el modo elige un playbook (feature, bug fix, refactoring, perf, prototype, shipping y 17 más), copia sus pasos en una lista de tareas y llama a las skills según las necesitan los pasos — /how y /why para entender, /architect para fijar tipos y forma de los módulos, /arena para intentos en paralelo, /interrogate para que otros modelos intenten romper el diff. El trabajo se reparte según la fuerza de cada modelo: el código a un modelo de código rápido, los cambios más difíciles y el criterio a un modelo de razonamiento fuerte. Corre en Cursor y se instala en Claude Code como plugin.
Mi workflow. projects-workflow-ai es la fuente de verdad desde la que arranco cada proyecto personal. Un problema se convierte en issues de GitHub (/problem-to-issues). Cada issue se convierte en una spec al estilo Kiro — requisitos, diseño, tareas, con una puerta de aprobación entre cada uno — que llega como pull request hacia staging (/spec-from-issue). Una sesión nueva implementa las tareas en una rama de feature y abre un segundo pull request (/implement-tasks). GitHub Actions mueve el issue en el tablero cuando hago merge: In Progress cuando entra su spec, Done cuando todas las casillas de tareas están marcadas en staging. Un PR de release deliberado promueve staging a main tras un preflight que reproduce la build de producción. Es el mismo ciclo que sigo con clientes como forward deployed engineer.
Dónde se alinean las etapas

Si se leen las filas de lado a lado, tres de las columnas coinciden mucho. Anthropic, AWS y yo separamos enmarcar el problema de especificar la solución, y los tres exigimos un plan escrito que el agente no puede saltarse antes de escribir código. Anthropic lo impone con el plan mode de Claude Code, que bloquea las ediciones hasta que una persona acepta el plan. AWS lo hace con etapas de diseño por unidad. Yo lo hago con tasks.md, que /implement-tasks debe leer completo — junto con requisitos y diseño — antes de tocar un archivo.
pstack rompe el patrón en la fila de especificar, y a propósito. Su README lo dice claramente: "no creo en planificar. la mejor spec es el código". Lo que hace en su lugar es obligar al código a ganarse su forma antes de escribirse. Todo código empieza nombrando la forma de sus datos; el código que cruza fronteras entre funciones pasa por /architect; una bifurcación que se puede resolver ejecutando algo se convierte en un prototipo desechable en lugar de una pregunta a un humano. El plan existe, pero como una lista de tareas copiada del playbook, no como un documento que alguien aprueba.
Las otras diferencias están en el tamaño de cada fila:
- Enmarcar. El
intent.mdde Anthropic es un documento separado y legible que alguien que no es ingeniero puede escribir con Claude y versionar mediante un conector de GitHub. La fase de Ideation de AWS va más allá: investigación de mercado, viabilidad, alcance, formación del equipo y mockups preliminares. pstack enmarca entendiendo primero el código —/howrecorre un subsistema,/whyrastrea la historia de una decisión,/in-your-own-wordste repite tu objetivo antes de empezar. El mío reduce el enmarcado al propio issue, porque quien enmarca el problema y quien lo construye son la misma persona. - Especificar. Anthropic, AWS y yo escribimos requisitos antes del diseño. AWS añade historias de usuario, personas, un modelo de dominio y diseño de contratos entre unidades. Yo escribo los requisitos en formato EARS (
WHEN … THEN the system SHALL …), el formato que usan las specs de Kiro. - Operar. Anthropic y AWS ponen agentes a observar señales de producción y escriben los hallazgos de vuelta al inicio del bucle. pstack incluye un paquete de automatización inactivo, benny, que clasifica reportes de incidencias desde Slack y luego reproduce y corrige los bugs confirmados con evidencia real de la UI — pero solo corre en las automatizaciones de Cursor. Mi bucle es el que se cierra antes:
/test-manualconstruye una suite de QA exploratoria contra la UI real, y sus fallos se convierten en nuevos issues. Todavía nada vigila producción por mí.
La cadena de artefactos

El playbook de Anthropic lo dice mejor que nadie: "la cadena de commits es también el registro de auditoría". El historial del chat de un agente desaparece a la mañana siguiente. Un archivo en el repositorio no, y el próximo agente — o la próxima persona — puede leerlo.
Cada enfoque deja un rastro distinto. AWS mantiene un archivo de estado (aidlc-state.md) más un registro de auditoría de cada puerta y decisión, para que una ejecución pueda detenerse y reanudarse entre sesiones y personas. Anthropic convierte cada artefacto en un disparador: un intent.md fusionado puede iniciar la pasada de spec sin interacción, un PR fusionado inicia el pipeline. El mío convierte cada merge en un cambio de estado, derivado por GitHub Actions de lo que se ha fusionado en staging.
El rastro de pstack es el que más se parece al código. En lugar de documentos antes del código, deja commits pequeños y ordenados, cada uno un futuro PR, apilados para que la secuencia se demuestre sola ante un revisor; un registro de decisiones que puedes versionar cuando lo que está en juego exige un registro auditable (/show-me-your-work); una skill de verificación del proyecto con un mapa de features, para que "funciona" sea algo que vuelves a ejecutar y no algo que crees (/create-verification-skill); y, tras una tarea larga, una edición de las propias skills (/reflect). Su principio build the lever explica por qué: la herramienta que hace o prueba el trabajo es el artefacto que un revisor puede volver a ejecutar.
Hay una regla mía que no encontré en ninguno de los tres, y que defendería: una feature tiene una sola spec durante toda su vida. Cuando un issue posterior cambia una feature existente, /spec-from-issue enmienda esa spec en su lugar y añade una sección de tareas ## Issue #N, en vez de crear una segunda spec que contradiga la primera.
Quién aprueba qué

Anthropic formula la regla de fondo como "el agente puede actuar hasta la puerta de producción y no puede cruzarla". AWS y yo coincidimos. pstack traza la línea en otro sitio:
- Anthropic nombra roles — originador, product owner, ingeniero, code owner, release manager, responsable del servicio — y preserva la separación de funciones: el agente que escribió el código no tiene forma de aprobarlo. Un hook
PreToolUsede Claude Code puede bloquear o preguntar, pausando un comando de despliegue hasta que una persona concreta lo apruebe. - AWS pone a un equipo en la puerta. Cada etapa termina con una aprobación, y tres puertas de verificación marcan los límites entre fases. La mob elaboration reemplaza al refinamiento del backlog: la IA pregunta, el equipo responde en la sala.
- pstack de Cursor mantiene la separación de funciones pero entrega la mayoría de las puertas a otros agentes. Su principio never block on the human dice: sigue adelante con el trabajo reversible, presenta el resultado y deja que el humano corrija después. Siempre se detiene ante escrituras irreversibles — force-push a ramas compartidas, despliegues, borrado de datos, mensajes a clientes. Antes de integrar un stack, su playbook de shipping exige un veredicto
PASSde un agente que no escribió el código y que ejecutó el cambio como lo haría un usuario; un CI en verde y la aprobación de un bot no cuentan. Sus playbooks de autopilot pueden llevar PR hasta el merge. - El mío tiene siete puertas y una persona. Las tres puertas de la spec usan
AskUserQuestion(aprobar o revisar), y los tres merges son pull requests que reviso en GitHub. "El usuario fusiona los PR; los agentes los abren" está escrito en el steering que carga cada agente.
La comparación de un vistazo
| Aspecto | AI-native SDLC de Anthropic | AI-DLC de AWS | pstack de Cursor | Mi workflow |
|---|---|---|---|---|
| Escrito para | Organizaciones de ingeniería con líderes de plataforma y seguridad | Equipos de 3 a 5 por feature, a menudo en AWS | Ingenieros que ejecutan muchos agentes en paralelo | Un ingeniero, muchos proyectos pequeños |
| Unidad de trabajo | Un intent, luego una spec | Una unidad de trabajo, en bolts | Una tarea llevada a un playbook, un stack de PR pequeños | Un issue de GitHub, una sección de spec |
| Spec escrita | intent.md → spec.md → plan.md | requisitos, historias, unidades, diseño NFR | Ninguna por defecto; primero la forma de los datos y los tipos | Requisitos EARS → diseño → tareas |
| Puertas | Seis, por rol; los hooks pueden imponerlas | Una por etapa, más tres puertas de fase | Veredictos de agentes; humanos para acciones irreversibles | Siete, todas mías |
| Verificación | Bucle de verificación por cambio, evals en CI | Etapa de build y test, etapa de CI | Probar en la app real; revisión con varios modelos | Todo local: build, lint, tests, E2E, preflight |
| Quién fusiona | Un code owner | El equipo | Los agentes pueden, tras un veredicto independiente | Solo yo |
| Cierra el bucle desde | Bandas de control en producción | Retroalimentación de Operation a Ideation | Reportes de Slack (solo Cursor), /reflect | Hallazgos de QA a nuevos issues |
| Herramientas | Nativo de Claude Code | Claude Code, Kiro y más | Cursor, o Claude Code como plugin | Kiro para specs, Claude Code para construir |
Claude Code y Kiro, etapa por etapa

Ninguno de estos enfoques exige una herramienta, pero cada uno fue moldeado por una. El playbook de Anthropic está escrito alrededor de Claude Code. AWS distribuye AI-DLC como harness para varios agentes, incluidos Claude Code (/aidlc …) y Kiro (el agente aidlc en el selector de agentes del IDE). pstack de Cursor está escrito para Cursor y se instala en Claude Code con /plugin marketplace add cursor/plugins y /plugin install pstack@cursor-plugins; allí es /pstack:poteto-mode, y un adaptador para Claude Code traduce los nombres de herramientas de Cursor a los de Claude Code. Las partes exclusivas de Cursor — automatizaciones, Bugbot, agentes en la nube — se omiten. No hay adaptador para Kiro. El mío reparte el trabajo: Kiro, porque su spec mode es requisitos → diseño → tareas, y Claude Code, porque sus skills, subagentes y herramientas MCP son donde construyo y verifico.
Este es el mapa de funciones que usaría en cada etapa, sigas el enfoque que sigas:
| Etapa | Claude Code | Kiro | Skill de pstack |
|---|---|---|---|
| Enmarcar | Skills para una entrevista repetible (/problem-to-issues); MCP para GitHub | Una sesión de spec iniciada desde el issue; steering manual con #name | /how, /why, /recall, /in-your-own-words |
| Especificar | Skills de la organización para los estándares; la misma pasada con claude -p cuando se fusiona intent.md | Specs requirements-first en EARS; powers para contexto de dominio | /architect; el playbook de prototipo para resolver una bifurcación ejecutándola |
| Planificar | Plan mode, que bloquea las ediciones hasta aceptar el plan | design.md y tasks.md; modo Supervised | La lista de tareas y el checkpoint de throughput del playbook; el playbook de plan multifase |
| Construir | CLAUDE.md / AGENTS.md, subagentes, worktrees, auto mode | Ejecución tarea por tarea; Autopilot más un archivo de steering de auto-aprobación | El playbook de feature, /tdd, /arena, /swarm |
| Verificar | Hooks; un navegador vía MCP; /code-review y /security-review | Hooks al guardar archivos; un bucle repeat de Workflows de implementar → verificar → revisar | /interrogate, /no-comments, /create-verification-skill, /blast-radius |
| Release | Code Review con un REVIEW.md; GitHub Actions; un hook PreToolUse que pregunta | Una receta de Workflows que espera una build de staging en verde y abre el PR de promoción; el Kiro CLI | Los playbooks de opening a PR, babysit y shipping |
| Operar | El Agent SDK o ejecuciones headless programadas; Claude Tag en Slack | Sesiones en la nube desde Kiro Web; powers de AWS para costo y seguridad | /why sobre Sentry, Datadog y otros MCP; /reflect y /correct |
Tres lecciones sirven para todas las herramientas. Primero, pon las reglas compartidas donde todos los agentes realmente las lean. Mi AGENTS.md se instala en la carpeta de steering de Kiro y se importa desde ~/.claude/CLAUDE.md, porque Claude Code no lee nada en las carpetas de Kiro — que es exactamente como los agentes siguieron abriendo PR contra main mucho después de que mis reglas de git dijeran staging. Segundo, una skill aconseja y un hook impone. El playbook de Anthropic dice que la skill hace que las violaciones sean raras y el hook las hace casi imposibles. Tercero, la versión de pstack de la misma idea: cuando te descubres corrigiendo a un agente por segunda vez, codifica la lección en la estructura — un lint, un tipo, un script — en lugar de más texto. /correct busca en tu historial esas correcciones repetidas.
Un ejemplo práctico: una lista de retiro del día
La teoría es barata, así que aquí va una feature pasada por los cuatro. Viene de un proyecto real mío, Perishable Shelf Stacking, que reemplazó la lista en papel de vida útil con la que trabajan los reponedores de supermercado por una tarjeta de producto con búsqueda. El problema nuevo, en palabras de los reponedores: "encontramos producto vencido a mitad del turno". La tarjeta sabe cuánto dura un producto. No le dice a nadie, al empezar el turno, qué hay que retirar hoy.
La feature: una lista de retiro del día — cada producto cuya fecha de etiqueta cae en las próximas 48 horas, agrupado por pasillo, en el teléfono. El mismo stack en las cuatro ejecuciones: Next.js y AWS Amplify Gen 2.

Con el playbook AI-native SDLC de Anthropic
Lo inicia la gerente de la tienda, no un ingeniero: una lluvia de ideas con Claude que termina en un intent.md versionado mediante el conector de GitHub. Los cinco encabezados de la plantilla obligan a hacer las preguntas que normalmente aparecen en la tercera semana:
# Intent: pull-today list

## Problem
Stockers find expired perishables mid-shift. The shelf-life list says
how long a product lasts, not which units on the shelf expire next.

## Proposed outcome
At shift start, a stocker opens one screen that lists, aisle by aisle,
every product whose sticker date falls in the next 48 hours.

## Affected users and systems
Stockers, store manager. Product catalog (Amplify Data), shelf locations.

## Constraints
Phone-sized screen, works on store Wi-Fi, no new hardware.

## Open questions
Is 48 hours right for every category, or does dairy need 72?
El product owner lo corrige y lo fusiona. Ese merge dispara la pasada de requisitos y diseño, guiada por skills de la organización (aquí, una skill de seguridad alimentaria que conoce las reglas de cada categoría), que produce spec.md. Una vez aceptada la spec, el ingeniero abre Claude Code en plan mode e itera hasta que el plan podría entregarse a alguien que nunca vio la conversación:
# Plan: pull-today list

## Files that change
- amplify/data/resource.ts      add stickerDate index on Product
- src/app/pull-today/page.tsx   aisle-grouped list
- src/lib/pull-window.ts        48 h window, category overrides

## Order of work
1. pull-window.ts with unit tests (boundaries: 47h59m, 48h, 48h01m)
2. data index + query
3. page, then E2E

## Risks
Time zones: sticker dates are store-local, Lambda runs in UTC.

## Proof
Vitest boundary cases green; Playwright E2E on the staging build.
La construcción empieza con el test de frontera que falla, Claude implementa hasta que pasa, y Code Review revisa el PR contra spec.md y plan.md usando las pasadas definidas en REVIEW.md. Un code owner aprueba; Claude no puede. El despliegue queda detrás de un hook que hace de puerta:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [{ "type": "command", "command": ".claude/hooks/production-gate.sh" }]
      }
    ]
  }
}
Y luego la parte que le falta a mi workflow: en producción, un agente programado vigila la cifra semanal de merma contra una banda de control. Si la merma no baja — o sube más allá de dos desviaciones estándar — el agente escribe su diagnóstico como el siguiente intent.md, y el bucle vuelve a empezar.
Con AI-DLC de AWS
La ejecución empieza con un solo comando, en Claude Code o en Kiro:
/aidlc Add a pull-today list to Perishable Shelf Stacking:
per aisle, every product whose sticker date falls in the next 48 hours.
El motor detecta un workspace brownfield y, antes de escribir ningún requisito, hace ingeniería inversa del código existente. Luego viene el paso que más se siente distinto: la mob elaboration. En lugar de que un product owner revise un documento, el desarrollador, la gerente de la tienda y un reponedor se sientan con la IA durante una hora más o menos. La IA pregunta — ¿qué cuenta como fecha de etiqueta para la fruta a granel? ¿quién actúa sobre la lista, y cuándo? — y sus respuestas se convierten en stories.md y personas.md en el momento.
La generación de unidades corta después la feature en unidades poco acopladas — digamos U1, la consulta e índice de la ventana de retiro, y U2, la vista agrupada por pasillo — con un grafo de dependencias, para que dos personas (o dos agentes) las construyan en paralelo. Cada unidad pasa por diseño funcional, requisitos no funcionales (la lista debe cargar con el Wi-Fi de la tienda en menos de dos segundos), diseño de infraestructura y generación de código, dentro de un bolt de alrededor de un día. Operation añade la configuración de observabilidad, y su etapa de retroalimentación apunta de vuelta a Ideation.
Para un equipo, es excelente: la respuesta del reponedor sobre la fruta a granel aparece en la primera hora, no en las pruebas de aceptación. Para un solo ingeniero son muchas etapas, y por eso AI-DLC trae perfiles de workflow que se saltan lo que un alcance concreto no necesita.
Con pstack de Cursor
La guía de pstack da un consejo por encima de todos: dale al agente un objetivo y una forma de comprobarlo, con tus propias palabras. Así que toda la ejecución parte de un único mensaje:
/poteto-mode add a pull-today list to perishable shelf stacking: per aisle,
every product whose sticker date falls in the next 48 hours. category
windows can differ. verify it on the real app before opening the pr.
El modo elige el playbook de feature y copia sus pasos en una lista de tareas. Primero, /how recorre el código de productos y ubicaciones en estantería. Como el código cruza fronteras entre funciones, /architect fija la forma antes de que nadie escriba lógica: un tipo PullWindow y una tabla de ventanas por categoría, en lugar de if (category === 'dairy') repartido por la página — el principio model the domain. Después el playbook escribe un checkpoint de throughput (qué bloquea, qué se paraleliza, qué comparte estado) y delega el código en el modelo de código configurado. Si hay varias formas válidas, pasa el trabajo a /arena para que intentos en paralelo muestren las alternativas y un juez cruzado elija.
La verificación se hace en la superficie que corresponde — la app real en un navegador, no "compila" — y "no concluyente" no cuenta como aprobado. Si el diseño es discutible, /interrogate pide a otros modelos que rompan el diff. El PR se abre con un título de Conventional Commits y un resumen breve: por qué, qué cambió, alcance, radio de impacto, verificación.
Lo que pstack no hace es preguntarle nada al reponedor. Nadie deja por escrito si los lácteos necesitan 72 horas; el mensaje de arriba dice "las ventanas por categoría pueden variar", y la tabla hace que cambiarlo sea barato. Esa es la apuesta de pstack: acierta con la forma de los datos y el requisito se convierte en una fila, no en una reescritura.
Con mi workflow
El mío es una secuencia de comandos, puertas y merges:
/problem-to-issues   "stockers find expired product mid-shift"
  -> issues.md: #52 feat: pull-today list by aisle   (create 1)
/spec-from-issue 52
  -> requirements.md  -> approve
  -> design.md        -> approve
  -> tasks.md         -> approve
  -> spec/52-pull-today-list  PR into staging, Refs #52
(merge)  -> #52 Todo -> In Progress
/implement-tasks 52-pull-today-list        # fresh session
  -> feat/52-pull-today-list  PR into staging, Closes #52
(merge)  -> #52 Done
staging -> main  release PR after the preflight
Los requisitos son donde ocurre la mayor parte del razonamiento, y el formato EARS los hace verificables línea por línea:
### Requirement 1: pull window

1. WHEN a stocker opens the pull-today list THEN the system SHALL show
   every product whose sticker date falls within the next 48 hours,
   grouped by aisle.
2. WHEN a product's category defines its own window THEN the system
   SHALL use that window instead of 48 hours.
3. IF no product falls in the window THEN the system SHALL say so
   instead of showing an empty list.
El requisito 2 es la pregunta abierta de Anthropic sobre los lácteos, atrapada aquí en la puerta de requisitos. tasks.md termina, por regla, con una tarea end-to-end y un checkpoint de build, lint y tests. /implement-tasks corre en una sesión nueva — las sesiones viejas arrastran contexto contaminado — en una rama creada desde staging, marca cada casilla según avanza y maneja un navegador real con Playwright MCP antes de abrir el PR. El PR de release espera una build de staging de Amplify en verde y un preflight local que reproduce la instalación de producción y compara el bundle del servidor con el límite de tamaño de Amplify, la lección de desplegar Next.js 16 en Amplify y de el error de TypeScript que solo CI podía ver. Si quiero todo orquestado en lugar de dirigido prompt a prompt, las recetas de Kiro Workflows ejecutan los mismos pasos como un único grafo y se detienen en un PR abierto.
Lo que dicen las cuatro ejecuciones
Los cuatro llegan más o menos al mismo código. Lo que cambia es quién tiene que estar en la sala, y cuándo descubres que te equivocaste. El mob de AWS encuentra primero la pregunta de la fruta a granel, porque el reponedor está en él. El playbook de Anthropic encuentra la pregunta de los lácteos en intent.md y el riesgo de zonas horarias en plan.md, y es el único que te dirá, semanas después, si la merma realmente bajó. pstack de Cursor encuentra antes que nadie los errores de diseño — un condicional disperso, una frontera sin test, un diff que otro modelo puede romper — y prueba el resultado en la app real, pero solo aprende del negocio lo que tú escribiste. El mío es el más rápido de la queja a staging para una sola persona, y el que más probablemente entregue una feature correcta que nadie mide.
Lo que tomo de los otros tres
- Un paso de plan dentro de la sesión de implementación (de Anthropic).
tasks.mddice qué;plan.mddice qué archivos, en qué orden, con qué riesgo y con qué prueba. Empezar/implement-tasksen plan mode cuesta un minuto y hace revisable la intención de la sesión antes de que edite nada. - Evals para mis propias skills (de Anthropic y del playbook de eval de pstack). Mis skills y mi steering cambian a menudo, y nada los prueba salvo la siguiente ejecución real. Una suite de evals construida a partir de 20 a 50 tareas reales, ejecutada cada vez que cambia una skill o un hook, es el seguro más barato que no estoy pagando.
- Una señal de producción que escriba un issue (de Anthropic y AWS). Incluso una sola alarma de CloudWatch que abra un issue en GitHub cerraría mi bucle sobre el comportamiento real y no sobre hallazgos de QA.
- Un verificador que no escribió el código (de pstack). Mi sesión de
/implement-tasksverifica su propio trabajo. La regla de pstack — solo cuenta el veredicto de un agente que no escribió el código, porque un autor comprueba lo que quiso construir — es una mejora barata: un subagente nuevo que ejecuta la feature enstagingy publicaPASSoFAILen el PR antes de que yo haga merge. - Codificar en la estructura las correcciones repetidas (de pstack). Cuando corrijo a un agente dos veces, el arreglo debería convertirse en un lint, un tipo o un script, no en otra línea de steering.
- Mob elaboration para el trabajo con clientes (de AWS). Con un cliente, una hora en la que la IA pregunta y las personas que tienen el problema responden es una mejor sesión de requisitos que cualquiera que haga yo solo — y encaja con cómo ya trabajo al lado del cliente.
Lo que conservo: la spec escrita, la regla de una spec por feature, el estado derivado de los merges, toda la verificación en local y agentes que nunca fusionan. pstack deja que los agentes integren un stack verificado; yo sigo queriendo a una persona en ese último botón.
¿Desde cuál deberías empezar?
- Eres una persona o un equipo muy pequeño que entrega muchos proyectos pequeños: empieza con algo parecido al mío. Menos etapas, puertas que realmente puedes cubrir y, aun así, un rastro de artefactos.
- Diriges la ingeniería de una organización con code owners, cumplimiento normativo y un equipo de plataforma: empieza con el playbook AI-native SDLC de Anthropic. Sus secciones de gobernanza — managed settings, hooks como puertas, separación de funciones — son la parte que la mayoría de los equipos se salta y luego necesita.
- Tu equipo tiene de tres a cinco personas y empieza una feature o un producto de cierto tamaño, sobre todo en AWS: prueba AI-DLC de AWS. Instala el harness, ejecuta
/aidlcsobre algo real y deja que el motor lleve el proceso mientras aprendes qué etapas puede saltarse tu alcance. - Ya sabes qué construir y quieres que cada cambio sea riguroso mientras varios agentes trabajan a la vez: instala pstack de Cursor, en Cursor o en Claude Code, y empieza cada tarea no trivial con
/poteto-mode. Combina bien con cualquiera de los otros tres: sus artefactos deciden qué, los playbooks de pstack deciden con cuánta calidad.
Elijas el que elijas, el núcleo compartido es lo que hay que copiar: escribe lo que importa, prueba el cambio en el sistema real y pon a una persona en cada puerta que no se pueda deshacer.
Si quieres un pipeline así para tu equipo, es parte de lo que ofrezco como servicios. También puedes contarme el problema.
Referencias
- Anthropic Academy: The AI-native SDLC playbook
- Blog de Claude: The AI-native SDLC playbook
- AWS: documento de definición del método AI-DLC
- Blog de AWS DevOps: AI-Driven Development Life Cycle
- awslabs/aidlc-workflows y su guía de fases y etapas
- Cursor: pstack, su guía y su adaptador para Claude Code
- jpmti2016/projects-workflow-ai
- Claude Code: extender Claude Code
- Claude Code: plugins
- Kiro: cómo funciona Kiro
- Kiro: specs