Aprender AI-DLC creando un juego, parte 15: los agentes y roles
Esta es la parte 15 de una serie sobre aprender AI-DLC creando un juego, World Rift Conflict, en Godot con un backend en AWS. La parte 1 lo preparó, y la parte 14 trató cómo recuerda AI-DLC. Esta trata de quién hace el trabajo: los agentes de AI-DLC.
Partes hasta ahora:
- Parte 1: configuración
- Parte 2: prueba de concepto
- Parte 3: pruebas E2E automáticas
- Parte 4: lo que encontraron las revisiones
- Parte 5: dentro de una etapa
- Parte 6: un intent de corrección
- Parte 7: ideación
- Parte 8: incepción
- Parte 9: un error de despliegue en AppSync
- Parte 10: esqueleto funcional
- Parte 11: retrospectiva
- Parte 12: guardas y hooks
- Parte 13: UI nueva y descargas
- Parte 14: las capas de memoria
- Parte 15: los agentes y roles (este artículo)
En resumen
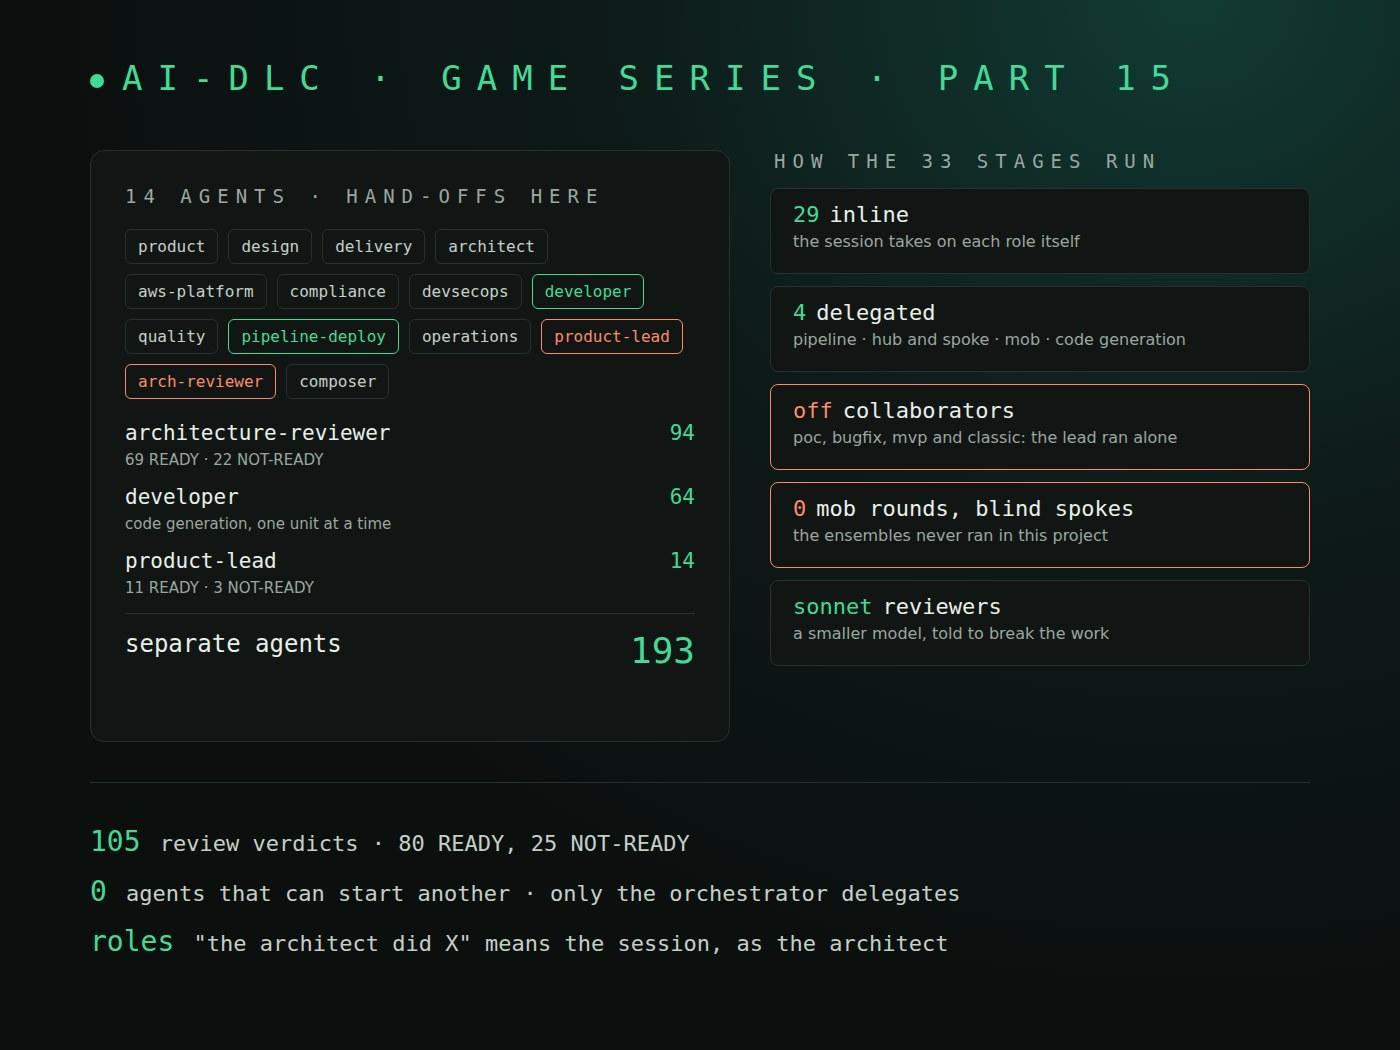
- AI-DLC trae 14 agentes: 11 expertos que hacen el trabajo, 2 revisores que solo lo cuestionan y un compositor que planifica flujos de trabajo.
- Casi siempre son roles, no agentes separados. 29 de las 33 etapas se ejecutan "inline": la sesión principal adopta ella misma el rol principal y los de apoyo.
- Los agentes separados se ejecutan en cuatro etapas, en las revisiones y para el compositor. En este proyecto fueron 193 entregas. 94 fueron al revisor de arquitectura y 64 al desarrollador.
- Los revisores dieron 80 veredictos READY y 25 NOT-READY. Usan un modelo más pequeño que la sesión, y aun así detectaron un riesgo para producción y un hueco de diseño que la etapa no había visto.
- Los conjuntos de varios agentes nunca se ejecutaron aquí. Todos los alcances que usé tienen
collaborators: off, así que cada etapa delegada ejecutó solo a su agente principal.
Catorce agentes
Cada agente es un archivo Markdown en .claude/agents/, con la descripción de su rol y su propia carpeta de notas de referencia en .claude/knowledge/. La del arquitecto tiene una plantilla de ADR y patrones de diseño guiado por el dominio, por ejemplo, y la del agente de calidad tiene patrones de estrategia de pruebas.
| Grupo | Agentes | Qué hacen |
|---|---|---|
| Expertos (11) | product, design, delivery, architect, aws-platform, compliance, devsecops, developer, quality, pipeline-deploy, operations | dirigen o apoyan las etapas |
| Revisores (2) | product-lead, architecture-reviewer | "Does not produce — only reviews and challenges." (No produce; solo revisa y cuestiona.) |
| Compositor (1) | composer | mide una tarea y propone el flujo más pequeño para ella |
Cada etapa nombra un agente principal y hasta tres de apoyo. Algunos ejemplos del grafo de etapas:
| Etapa | Principal | Apoyo |
|---|---|---|
| Intent Capture | product | architect |
| Feasibility | architect | aws-platform, compliance |
| Practices Discovery | pipeline-deploy | quality, developer, devsecops |
| User Stories | product | design, developer, quality |
| Code Generation | developer | ninguno |
| Build and Test | quality | devsecops |
El arquitecto es el que más dirige: siete etapas, de Feasibility a NFR Design. Compliance no dirige ninguna; solo apoya.
Ningún agente puede iniciar otro. Los 14 archivos bloquean la herramienta Task, y el framework lo dice sin rodeos: "Agents do NOT invoke each other — only the orchestrator delegates." (Los agentes no se invocan entre sí; solo delega el orquestador.) El orquestador es la sesión principal que ejecuta /aidlc.
Roles, no procesos
El grafo de etapas da a cada etapa un modo. 29 de las 33 etapas son inline, donde "the conductor adopts every voice, zero dispatches" (el conductor adopta todas las voces, sin delegar nada). La sesión principal trabaja la etapa como el agente principal, luego añade la visión de cada rol de apoyo y después lo une todo. El archivo de la etapa lo dice directamente: "Take on lead_persona: you work the stage as that agent." (Adopta el rol principal: trabajas la etapa como ese agente.) Y: "Do NOT dispatch a support agent on an inline stage."
Así que cuando el registro dice "el agente de producto escribió los requisitos", no se ejecutó ningún agente separado. Mi sesión leyó el archivo y el conocimiento del agente de producto y escribió en ese rol.
Cuatro etapas entregan el trabajo a agentes separados, con una de tres formas:
| Etapa | Modo | Forma |
|---|---|---|
| Reverse Engineering | pipeline | una cadena: el desarrollador analiza el código, el arquitecto escribe la base de conocimiento, y cada eslabón ve todo el trabajo anterior |
| Practices Discovery | subagent | centro y radios: el principal hace el borrador, cada agente de apoyo lo revisa sin ver a los demás, y el principal lo integra |
| User Stories | mob | "one room, cross-talk, dissent recorded" (una sala, conversación cruzada, desacuerdos registrados) |
| Code Generation | subagent | el desarrollador construye la unidad |
Las revisiones y el compositor también son agentes separados. Un revisor es "a separate sub-agent" que lee lo que produjo la etapa y escribe un archivo con su veredicto.
Lo que se ejecutó de verdad aquí
Contado en la auditoría de los seis trabajos: 193 entregas completadas a agentes separados.
| Agente | Entregas |
|---|---|
| architecture-reviewer | 94 |
| developer | 64 |
| product-lead | 14 |
| pipeline-deploy | 6 |
| otros o sin registrar | 15 |
Las 64 del desarrollador son sobre todo Code Generation, una por unidad y más cuando una construcción se quedó sin espacio. Las 6 del agente pipeline-deploy son de Practices Discovery. No aparece ninguna entrega al compositor en la auditoría.
El hallazgo más grande es lo que no se ejecutó. Todos los alcances que usé, poc, bugfix, mvp y classic, fijan collaborators: off. Solo enterprise lo activa. Con esa opción desactivada, "the lead runs alone, on every topology" (el principal trabaja solo, en todas las formas). Así:
- Reverse Engineering se ejecutó como una cadena de un solo eslabón. Los cinco eslabones completados son del agente desarrollador. El arquitecto nunca añadió su parte. "The developer agent both scanned and wrote the nine knowledge base files." (El desarrollador analizó y además escribió los nueve archivos de la base de conocimiento.)
- Practices Discovery tuvo al principal y ninguna revisión a ciegas de los agentes de calidad, desarrollo y seguridad.
- User Stories no tuvo ronda en grupo. Una de las opciones de aprendizaje que AI-DLC ofreció en esa etapa decía literalmente "Mob round did not run with collaborators off".
Yo no lo elegí. Venía con los alcances, y solo lo descubrí al escribir este artículo.
Los revisores
Los revisores son la parte que sí se ejecutó, y a menudo. Dieron 105 veredictos aquí:
| Revisor | READY | NOT-READY |
|---|---|---|
| architecture-reviewer | 69 | 22 |
| product-lead | 11 | 3 |
A un revisor se le pide "Refute, don't confirm" (refuta, no confirmes): READY es "the verdict it fails to reach after trying to break the artifact" (el veredicto al que no logra llegar después de intentar romper el documento). Un hallazgo "backed only by opinion is a suggestion, not grounds for NOT-READY" (basado solo en opinión es una sugerencia, no motivo para NOT-READY). Las etapas de requisitos y de diseño tienen una pasada de revisión consultiva. Las etapas de diseño por unidad de Construction tienen un ciclo adversarial de hasta dos pasadas. El revisor de una unidad no puede leer los archivos de las demás.
Algunos veredictos NOT-READY, según los archivos de revisión:
- El diseño del kit de pruebas de extremo a extremo: ningún paso comprobaba, antes de arrancar, que el grupo de usuarios de una versión de prueba fuera el de pruebas, "so a stale export pointing at production could run" (así que podía ejecutarse una exportación antigua que apuntara a producción). La misma revisión encontró tres tareas sin ningún componente responsable, y eso se convirtió en una regla del proyecto.
- Las historias de usuario del juego: "The walking-skeleton boundary does not hold together." Una historia del esqueleto dependía de otra que estaba fuera de él.
- El diseño de una unidad de UI: fijar desde el código el valor de un deslizador vuelve a emitir su señal de cambio, "which would rebalance recursively" (lo que reequilibraría en bucle).
Los dos revisores tienen fijado model: sonnet con effort: medium. Los otros 12 agentes heredan el modelo de mi sesión, que la entrada de configuración de mi registro anota como Claude Opus 5.5. Así que un modelo más pequeño revisó el trabajo de uno más grande, y en la construcción del juego los dos revisores devolvieron 22 de 43 primeras pasadas.
Fricciones
- Un límite de gasto detuvo a un agente a mitad de borrador. La solución se convirtió en regla del proyecto: "resume that same agent after the person says to continue, instead of starting a new one, so its work so far is kept." (Reanudar el mismo agente, no empezar uno nuevo, para no perder su trabajo.)
- Una construcción de 45 tareas superó a un solo agente. Se detuvo por un límite de créditos y otra vez en la tarea 29 para no salirse de su contexto. Un agente nuevo, con las notas de traspaso del primero, terminó el resto.
- Los agentes solo conocen sus propias carpetas. Leen
.claude/knowledge/, no las skills de Godot que yo tenía instaladas. Esas les llegaron mediante una sección en elCLAUDE.mdraíz y una regla del proyecto. - Un revisor puede equivocarse en los detalles. NOT-READY no siempre tiene razón. Acepté algunos hallazgos como abiertos en vez de corregirlos, y etapas posteriores los recogieron.
Lo que me diría a mí mismo
- Revisa
collaboratorsen tu alcance. Si quieres los conjuntos de agentes, las revisiones a ciegas y la ronda en grupo, elige un alcance que los active o cambia la opción. Espera más entregas y más coste. - Lee "el arquitecto hizo X" como "la sesión, en el rol de arquitecto". Solo las cuatro etapas delegadas y las revisiones se ejecutan como agentes separados.
- Mantén los revisores. Una segunda mirada de otro modelo, al que se le pide romper el trabajo, devolvió la mitad de las primeras pasadas de revisión del juego, con problemas reales.
- Sabe qué modelo usa cada agente.
aidlc config models --showlo muestra. Aquí, los revisores en Sonnet y todos los demás en el modelo de la sesión.
Qué sigue
Más análisis a fondo de los mismos registros hasta que empiece el próximo trabajo. El siguiente de la lista es los alcances y el compositor: cómo elige AI-DLC qué etapas se ejecutan.