Aprender AI-DLC creando un juego, parte 14: las capas de memoria
Esta es la parte 14 de una serie sobre aprender AI-DLC creando un juego, World Rift Conflict, en Godot con un backend en AWS. La parte 1 lo preparó, y la parte 13 cerró el trabajo de UI con la primera publicación para escritorio. Esta es un análisis a fondo: cómo recuerda AI-DLC lo que aprendió.
Partes hasta ahora:
- Parte 1: configuración
- Parte 2: prueba de concepto
- Parte 3: pruebas E2E automáticas
- Parte 4: lo que encontraron las revisiones
- Parte 5: dentro de una etapa
- Parte 6: un intent de corrección
- Parte 7: ideación
- Parte 8: incepción
- Parte 9: un error de despliegue en AppSync
- Parte 10: esqueleto funcional
- Parte 11: retrospectiva
- Parte 12: guardas y hooks
- Parte 13: UI nueva y descargas
- Parte 14: las capas de memoria
- Parte 15: los agentes y roles
En resumen
- Un agente lo olvida todo entre sesiones. La memoria de AI-DLC son cuatro archivos Markdown de reglas que se leen al empezar cada sesión: org, team, project y phase.
- Las capas solo suman. Una capa más estrecha puede concretar una regla más amplia, pero una regla que contradice a otra más amplia se rechaza, no se aplica.
- Cada archivo tiene un solo autor. El framework trae
org.mdy los archivos de fase. Una herramienta escribeteam.mden la entrevista de prácticas. Las reglas aprendidas van aproject.md. - Al final de cada etapa, AI-DLC pregunta "Anything to add for next time?" (¿algo que añadir para la próxima vez?). En seis trabajos eso escribió 53 reglas, y la auditoría tiene una fila
RULE_LEARNEDpor cada una. - Las 53 fueron al archivo del proyecto. 41 son correcciones a cómo el agente trabaja conmigo, no datos sobre el juego.
Por qué un agente necesita memoria
Cada sesión de Claude Code empieza vacía. Lo que un agente aprendió ayer, por ejemplo que ampx termina con código 0 después de un despliegue fallido, hoy ya no está, salvo que se haya escrito donde la siguiente sesión lo vaya a leer.
AI-DLC lo escribe como reglas, en archivos Markdown normales dentro del repositorio, en aidlc/spaces/default/memory/. Se hace commit de ellos como del código, así que la memoria tiene historial y puedo leer y revisar cada línea.
Cuatro archivos, una cadena
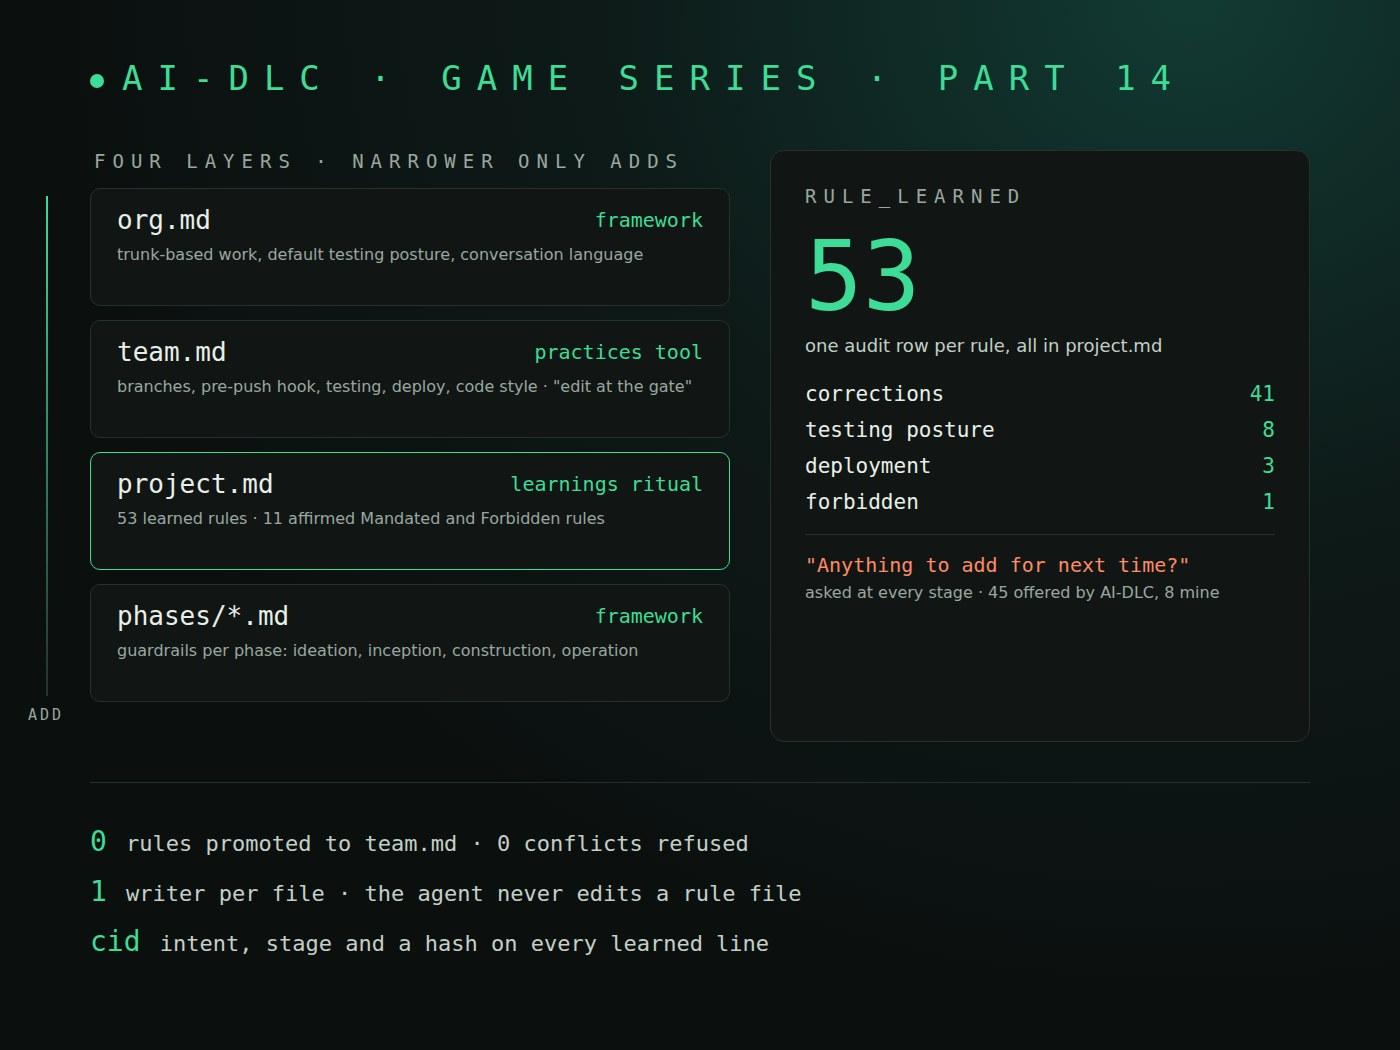
El framework llama a este orden "a strict-additive five-layer chain" (una cadena de cinco capas estrictamente aditiva): org → team → project → phase → stage. La quinta capa, stage, está "reserved for future use" (reservada para el futuro), así que en la práctica hay cuatro:
| Capa | Archivo | Qué contiene aquí | Quién lo escribe |
|---|---|---|---|
| Org | org.md | valores por defecto del framework: trabajo sobre una sola rama, la postura de pruebas por defecto, las reglas del idioma de la conversación | el framework |
| Team | team.md | cómo trabajamos: ramas, el hook pre-push, postura de pruebas, despliegue, estilo de código | una herramienta, en la entrevista de prácticas |
| Project | project.md | 53 reglas aprendidas, más 11 reglas Mandated y Forbidden afirmadas | el ritual de aprendizajes y la herramienta de prácticas |
| Phase | phases/*.md | reglas por fase, por ejemplo "no implementation details in ideation artifacts" | el framework |
"Estrictamente aditiva" significa que cada regla aplicable llega al agente y ninguna se descarta al ejecutar. Una regla más estrecha puede especializar una más amplia, pero no anularla. La guía de lectura del framework lo dice claro: "A narrower statement that contradicts broader policy is an admission error, not an override." (Una regla más estrecha que contradice a una más amplia es un error de admisión, no una anulación.)
Cómo llegan las reglas a cada agente
Claude Code las carga con su propio mecanismo de CLAUDE.md. .claude/CLAUDE.md importa .claude/rules/aidlc.md, y ese archivo tiene siete importaciones con @, una por archivo de memoria.
Las importaciones no apuntan a los archivos que yo edito. Apuntan a aidlc/active-memory/, una copia que git ignora y que el motor reescribe al empezar la sesión y en cada paso. Cada copia lleva una primera línea extra: "AI-DLC keeps this copy in step with aidlc/spaces/default/memory/org.md. Edit that file; this copy is replaced." (AI-DLC mantiene esta copia al día con el original. Edita ese archivo; esta copia se reemplaza.)
Los agentes auxiliares reciben las reglas por una segunda vía, para que ninguno se las pierda: en cada entrega a un agente auxiliar, AI-DLC añade el paquete completo de reglas a sus instrucciones. En este proyecto ese paquete pesa unos 30 KB. Por eso el modo automático de Claude Code rechazó una vez una entrega: algo había cambiado la llamada después de que el modo automático la revisara.
Un autor por archivo
org.md y los archivos de fase vinieron con el framework. No los he cambiado, y sus secciones ## Corrections siguen vacías.
team.md dice en su cabecera: "Edit at the gate, not directly." (Edítalo en la aprobación, no directamente.) Lo escribe practices-promote, una herramienta que se ejecuta cuando apruebo la entrevista de prácticas. Reemplaza cinco secciones de team.md y añade las reglas firmes a project.md. El código de la herramienta explica por qué lo hace una herramienta y no el agente. Cuando la etapa le pedía al modelo escribir los archivos él mismo, el modelo "hallucinates a sensitive-file permission policy that does not actually exist" (se inventa una política de permisos que no existe), se detiene y "the workflow bricks" (el flujo se queda bloqueado). Con una herramienta, esa ruta nunca es algo que escriba el modelo.
La entrevista se hizo tres veces aquí:
- 2026-10-27: la primera fijó la fusión local con un hook
pre-push, un backend de pruebas separado y las pruebas de aceptación primero. Añadió 2 reglas Mandated, como "ALWAYS tell the person when a push to GitHub is due", y 3 Forbidden, como "NEVER push to GitHub from an agent". - 2026-10-29: para el juego en sí. Una rama por unidad, el mínimo de cobertura del 80 %, pruebas de extremo a extremo con varios clientes y 6 reglas firmes más: el límite de 50 $ al mes, jugadores de 13 años o más, nada de pagar para ganar, ningún dato de tarjetas, el pago desactivado hasta conocer los costes y datos cuyas condiciones permitan usarlos en un juego.
- 2026-11-06: para el trabajo de UI. Pruebas de que la pantalla cabe, tamaños de ventana y la comprobación de contraste. Ninguna regla firme nueva.
project.md recibe todo lo aprendido por el camino.
El ritual de aprendizajes
El ritual se ejecuta al final de cada etapa, entre "la etapa ha terminado" y la aprobación. El framework lo describe como "tool-as-actor": una herramienta, aidlc-learnings.ts, busca lecciones candidatas en el diario de la etapa y las muestra, y "the user decides keep / heading / scope" (la persona decide si se guarda, en qué sección y con qué alcance). La pregunta "Anything to add for next time?" se hace aunque no haya candidatas.
Una nota guardada se convierte en una línea de project.md, bajo una sección elegida según su tipo: las notas de pruebas van a Testing Posture, las prohibiciones a Forbidden y el resto a Corrections. Cada línea termina con una fecha y un comentario oculto:
- Deploy wrappers judge success by the tool's error lines as well as its exit code, because ampx exits 0 after a failed hotswap. (learned 2026-10-30) <!-- cid:261029-game-idea-brainstorm:code-generation:3317316715a5… -->
El comentario nombra el trabajo, la etapa y un hash del texto. El hash impide que la misma lección se escriba dos veces, por ejemplo después de un fallo. El agente nunca edita el archivo él mismo: "The orchestrator never Edits a rule or sensor file directly."
Contado en este proyecto:
- 53 reglas aprendidas en
project.mdy 53 filasRULE_LEARNEDen la auditoría. Coinciden una a una. - 45 las propuso AI-DLC y 8 fueron mías, añadidas en la pregunta "Anything to add?".
- Por sección: Corrections 41, Testing Posture 8, Deployment 3, Forbidden 1.
- Por trabajo: la construcción del juego 35, el kit de pruebas de extremo a extremo 10, la prueba de concepto de inicio de sesión 8, el trabajo de UI 0.
Qué dicen las reglas
Las más útiles salieron casi todas de algo que falló. Algunas, palabra por palabra:
- "Before the first deploy of an AppSync JavaScript resolver, check each one with
aws appsync evaluate-code…" Salió del error de despliegue de la parte 9. - "Code that reads a secret or key trims surrounding whitespace before using it… (the stored Stripe key broke every checkout call this way)." Un salto de línea al final de la clave guardada rompió todos los pagos.
- "A server host or its start-up script is checked by a real fresh deploy before the unit's checkpoint… three live-host start-up defects passed every local test and showed only on the first real boot."
- "
npm audit --omit=devat a root that holds only devDependencies checks nothing and always passes."
El otro tipo trata del propio agente. 41 de las 53 están en Corrections, y la mayoría trata de cómo debe trabajar conmigo: "Write every guided question with at most four options… so it fits one picker." (Cada pregunta guiada con cuatro opciones como mucho, para que quepa en un selector.) "When offering the person choices…, explain what each option is and why it matters." (Al ofrecer opciones, explicar qué es cada una y por qué importa.) "Code Generation may ask the person questions when a fact found while planning contradicts… the approved requirements, instead of guessing." (Code Generation puede preguntar en vez de adivinar.)
Lo que no esperaba
- Nada llegó a la capa del equipo. Las 53 reglas aprendidas fueron a
project.md.team.mdyorg.mdno tienen ninguna. En un proyecto de una sola persona tiene sentido, pero significa que el archivo del equipo solo cambia en una entrevista. - La comprobación de conflictos nunca se activó. No encontré ningún aprendizaje rechazado, en conflicto o duplicado en ningún archivo de auditoría. O mis notas nunca contradijeron las reglas de org, o la comprobación no tuvo nada que atrapar. Los registros no me dicen cuál.
- El ritual se calla a medida que se acumulan las reglas. El trabajo de UI preguntó "Anything to add?" nueve veces. Ocho respuestas fueron "Nothing to add", y la novena, una nota sobre tamaños de ventana y de texto, no se convirtió en regla.
- El archivo del equipo se quedó desfasado. Antes de la tercera entrevista, el análisis del código encontró tres líneas de
team.mdque ya no coincidían con el código. Decía ocho comprobacionespre-pushcuando había 16, y decía que la imagen base estaba fijada por digest cuando lo estaba por etiqueta. La entrevista tomó el archivo como punto de partida y corrigió esos datos. - La herramienta escribe cada línea que recibe. Cuando la tercera entrevista no tuvo ninguna regla firme nueva, el agente escribió un comentario HTML en lugar de las palabras "No new rule", "because the promotion tool appends every non-comment line to
project.mdas a rule" (porque la herramienta añade como regla cada línea que no sea un comentario). - AI-DLC no conoce tus otras herramientas. Sus agentes solo leen sus propias carpetas de conocimiento. Las skills de Godot que tenía instaladas les llegaron solo mediante una sección en el
CLAUDE.mdraíz y una regla del proyecto guardada en una pregunta de aprendizajes.
Lo que me diría a mí mismo
- Responde siempre a la pregunta de aprendizajes. Cuesta una línea, y es el único camino de "el agente se equivocó en esto" a "la próxima sesión lo sabe". Solo 8 de las 53 reglas fueron notas mías, pero entre ellas están las de
EvaluateCodeyampxde arriba, y la que trajo las skills de Godot. - Escribe el motivo dentro de la regla. "because ampx exits 0 after a failed hotswap" es lo que permite a un agente posterior aplicar la regla a un caso para el que no se escribió.
- Lee
project.mdde vez en cuando. 53 reglas es mucho contexto en cada sesión. Las reglas sobre el comportamiento del propio agente merecen una revisión: ¿siguen siendo ciertas, hay alguna repetida? - No edites la copia activa.
aidlc/active-memory/se reemplaza en el siguiente paso. Editaaidlc/spaces/<space>/memory/, yteam.mdsolo mediante la entrevista.
Qué sigue
La parte 15 es la otra mitad de cómo funciona AI-DLC: los agentes. Catorce roles, cuáles se ejecutaron de verdad como agentes separados en este proyecto, y los que nunca llegaron a ejecutarse.