Cómo sigue la industria el trabajo con IA en muchos proyectos
Trabajo en varios proyectos personales a la vez, y en todos ellos un agente de IA escribe la mayor parte del código. Eso hace cada sesión rápida, y agranda un problema: cuando vuelvo a un proyecto después de cuatro días, ¿dónde me quedé y qué sigue? El chat del agente ya no está, el plan que tenía en la cabeza tampoco, y la idea que tuve a mitad de la última sesión («esta pantalla también necesita un estado vacío») solo se pierde si no la anoté.
Mi respuesta es aburrida a propósito: GitHub Issues y un solo tablero de GitHub Project. Cada funcionalidad, bug o idea se convierte en una issue en el momento en que aparece, cada issue llega sola al tablero, y los merges mueven su estado, así que empiezo cualquier proyecto abriendo su vista del tablero, no haciendo memoria. Se integra con lo que ya uso, Claude Code y GitHub, sin otra aplicación que revisar.
Quería saber si así lo resuelve la industria, o si soy el único que sigue creando issues mientras los agentes escriben el código. Este artículo repasa la investigación sobre por qué retomar el trabajo cuesta tanto, los tres lugares donde los equipos guardan hoy el «dónde me quedé», y cómo se compara mi configuración.
TL;DR
- Lo caro es retomar, y la investigación lo deja claro. Los programadores casi nunca vuelven a editar en el primer minuto tras retomar una tarea interrumpida. La mayoría primero navega por el código para reconstruir el contexto, y en cerca del 30 % de las sesiones la primera edición llega más de 30 minutos después. Escribir dónde estás y qué sigue antes de parar reduce ese costo de forma medible.
- Los agentes de IA lo empeoran, no lo mejoran. El agente olvida entre sesiones, y usar varios agentes a la vez significa más trabajo a medio terminar. METR dice ahora que sus mediciones de tiempo no son fiables para quienes usan varios agentes, porque cambian a otra tarea mientras un agente trabaja.
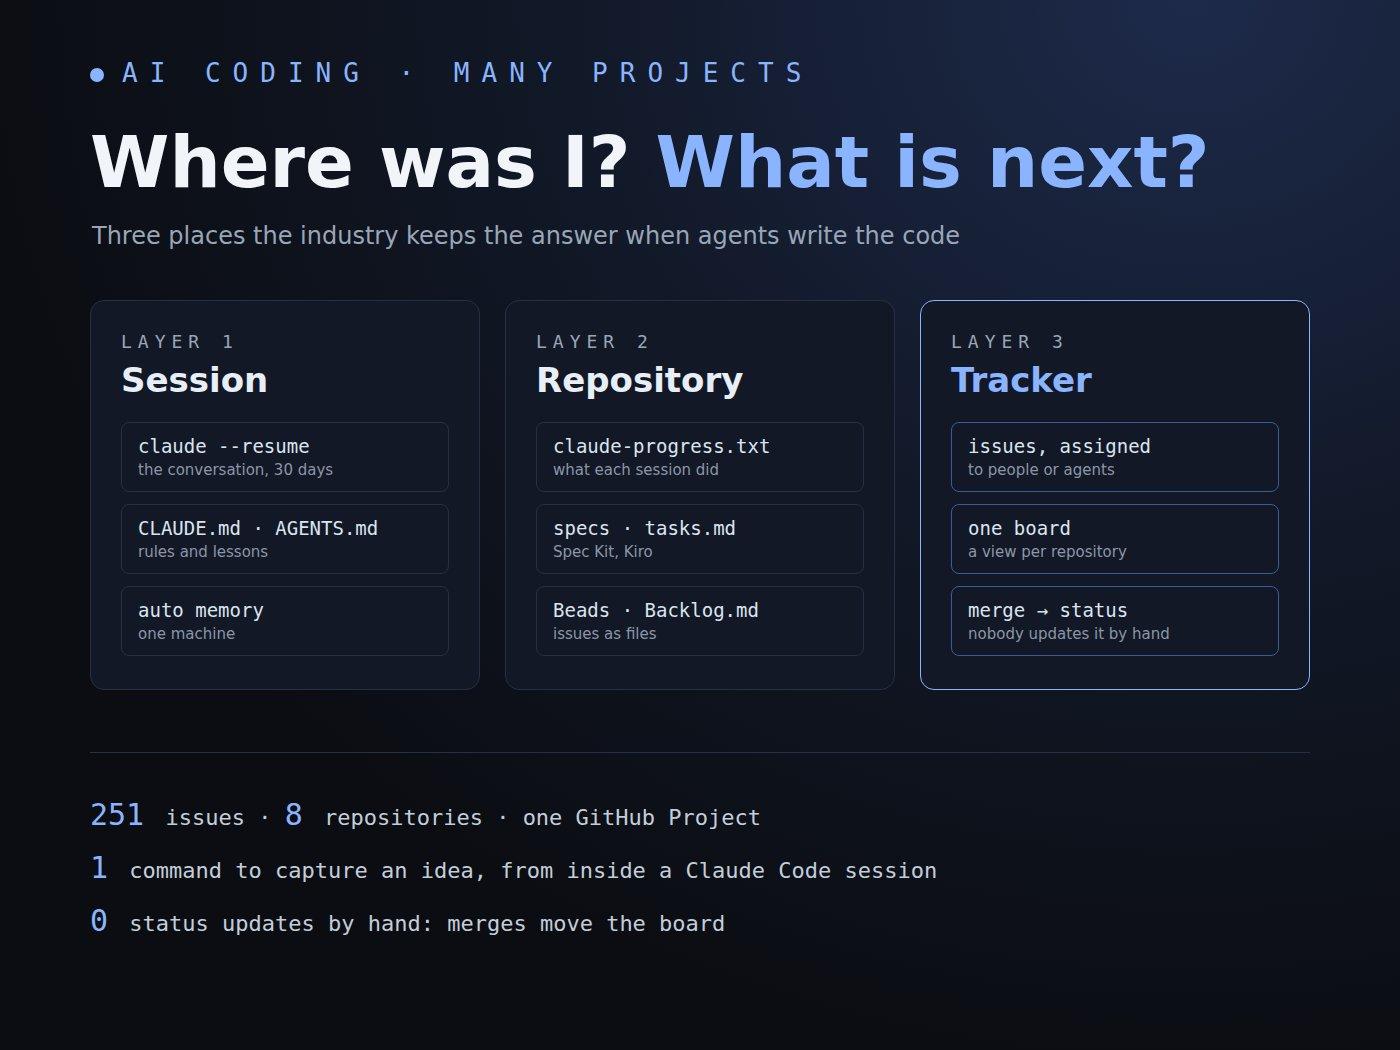
- La industria guarda el «dónde me quedé» en tres lugares: la sesión (reanudar y archivos de memoria en Claude Code), el repositorio (archivos de progreso, specs, archivos de tareas como Beads o Backlog.md) y el gestor de issues (GitHub Issues, Linear, Jira), donde los agentes ya son asignables: toman una issue y vuelven con un pull request.
- Responden preguntas distintas. La sesión recuerda la conversación, el repo recuerda el plan de un proyecto, y solo el gestor de issues muestra todos los proyectos y todas las ideas capturadas en un solo lugar sin abrir nada.
- Mi configuración es la capa del gestor de issues más un poco de la del repositorio, y la industria se ha movido hacia ella: GitHub, Linear y Atlassian tratan hoy «asignar la issue» como la forma de pasar trabajo a un agente. Lo que tomo de los demás: una nota escrita de listo para retomar cuando se detiene una sesión, y un archivo de progreso para las ejecuciones largas de agentes.
Por qué cuesta tanto el «¿dónde me quedé?»
El costo de cambiar de tarea es una de las cifras más citadas del software, y casi siempre mal. «Se tarda 23 minutos en volver a concentrarse después de una interrupción» se atribuye a Gloria Mark, profesora en UC Irvine. La cifra sale de una entrevista con Gallup de 2006, en la que dijo que el trabajo interrumpido y retomado el mismo día «se retomaba, en promedio, en 23 minutos y 15 segundos», y que «hay unas dos tareas intermedias antes de volver a la tarea original». Su estudio revisado por pares con 24 trabajadores del conocimiento, «No Task Left Behind?» (CHI 2005), da 25 minutos y 26 segundos, con una desviación estándar de casi 55 minutos. Ambas cifras miden el tiempo hasta que la gente volvió a una tarea después de hacer otras cosas, no el tiempo para recuperar la concentración. Su estudio de laboratorio posterior, «The Cost of Interrupted Work» (CHI 2008), encontró otra cosa: las personas interrumpidas trabajaban más rápido para compensar, «pero a un precio: más estrés, más frustración, presión de tiempo y esfuerzo».
Las cifras que más importan para quien programa vienen de Chris Parnin y Spencer Rugaber, que analizaron 10 000 sesiones de programación grabadas de 86 programadores y encuestaron a otros 414, en «Resumption strategies for interrupted programming tasks» (Software Quality Journal, 2011):
- Solo en el 10 % de las sesiones la actividad de programación se retoma en menos de un minuto tras una interrupción, y solo en el 7 % el programador empezó a editar sin navegar antes a otros lugares del código.
- «En cerca del 30 % de las sesiones, el retraso hasta la primera edición supera los 30 minutos».
- Los programadores reconstruyen el contexto leyendo código, ejecutando el programa, mirando el diff, buscando TODOs, e incluso dejando un error de compilación a propósito como señal para encontrarla después. Y el 77 % respondió que sigue activamente el estado de sus tareas tomando notas: en el gestor de bugs, en notas, en el código o en papel.
Dos hallazgos más explican por qué escribirlo es la solución y no solo un buen hábito:
- La tarea sin terminar sigue corriendo en tu cabeza. Sophie Leroy (2009) lo llamó residuo atencional: quien deja una tarea sin terminar sigue pensando en ella y rinde peor en la siguiente. En un estudio posterior con Theresa Glomb, «Tasks Interrupted» (2018), un breve plan listo para retomar, escrito antes de cambiar de tarea, redujo ese residuo y evitó la caída de rendimiento.
- Un plan basta para soltarlo. E. J. Masicampo y Roy Baumeister mostraron en «Consider It Done!» (2011) que las metas sin cumplir causan pensamientos intrusivos y perjudican otras tareas, y que permitir a los participantes formular planes concretos para esas metas eliminó esos efectos, aunque la meta siguiera sin cumplirse. Es la investigación detrás del lema de David Allen en Getting Things Done: «Tu mente sirve para tener ideas, no para guardarlas».
Qué cambian los agentes de IA
Un agente no elimina el problema; lo cambia de lugar. Cada sesión de Claude Code empieza con una ventana de contexto nueva, como dice su documentación de memoria, así que al agente hay que decirle cada vez cómo están las cosas. Y como los agentes trabajan mientras esperas, cambias más de tarea. El ensayo aleatorizado de METR con desarrolladores experimentados de código abierto a principios de 2025 los encontró un 19 % más lentos con herramientas de IA mientras creían ir más rápido. Su actualización de febrero de 2026 considera ese resultado superado, y añade el detalle que importa aquí: sus mediciones del tiempo por tarea no son fiables para quienes usan varios agentes de IA, porque los desarrolladores «a menudo trabajaban en una tarea no relacionada mientras esperaban a que el agente terminara».
Más proyectos, más agentes y más trabajo en paralelo significan más tareas a medio hacer. Algo fuera de tu cabeza, y fuera de cualquier chat, tiene que guardarlas.
Tres lugares para guardar el «dónde me quedé»
1. La sesión: reanudar la conversación
La capa más barata es la memoria del propio agente, y Claude Code ya tiene mucha (documentación de sesiones):
claude --continuereabre la última sesión de un directorio,claude --resumeabre un selector yclaude --from-pr <n>encuentra la sesión vinculada a un pull request.- Las sesiones se pueden nombrar: la guía de buenas prácticas sugiere usar
/rename oauth-migrationen un trabajo de varios días, para queclaude --resume oauth-migrationlo retome después, con sus checkpoints. CLAUDE.mdguarda las reglas que escribes tú, y la memoria automática guarda lo que Claude aprende por su cuenta, cargadas al inicio de cada sesión. AGENTS.md es la versión compatible entre herramientas: «un README para agentes», hoy bajo la Agentic AI Foundation de la Linux Foundation.- Claude puede llevar una lista de tareas durante un trabajo de varios pasos, y
CLAUDE_CODE_TASK_LIST_IDcomparte una lista entre sesiones.
Esta capa es excelente para la mañana siguiente en el mismo proyecto. Para mi caso es débil: las transcripciones se guardan 30 días por defecto y en una sola máquina, los archivos de memoria guardan reglas y lecciones, no un backlog, y nada en una sesión me dice cuál de ocho proyectos abrir.
2. El repositorio: el plan viaja con el código
La segunda capa escribe el estado del trabajo en archivos del repo, donde cualquier sesión, agente o persona los encuentra.
- Archivos de progreso. El artículo de ingeniería de Anthropic «Effective harnesses for long-running agents» (Justin Young, noviembre de 2025) hace que un primer agente prepare
init.sh, un archivoclaude-progress.txtcon el registro de lo que han hecho los agentes, y una lista de funcionalidades en JSON donde todas empiezan fallando. Cada sesión posterior se orienta igual: lee el log de git y los archivos de progreso para ponerse al día, y elige la funcionalidad de mayor prioridad que aún no está hecha. Eligieron JSON en vez de Markdown porque es menos probable que el modelo lo reescriba a la ligera. - Specs con lista de tareas. Spec Kit de GitHub, anunciado por Den Delimarsky en septiembre de 2025, va de la spec al plan y a
tasks.md, enspecs/<feature>/, y trata las specs como artefactos vivos y ejecutables que evolucionan con el proyecto. Las specs de Kiro hacen lo mismo conrequirements.md,design.mdytasks.md, donde cada tarea se marca en progreso o completada para seguir la implementación. - Bancos de memoria. El Memory Bank de Cline es una carpeta de archivos Markdown, entre ellos
activeContext.md(foco actual y próximos pasos) yprogress.md(qué funciona, qué falta), con una regla que obliga a leerlos todos al inicio de cada tarea. - Gestores de issues dentro del repo. Backlog.md guarda cada tarea como un archivo
.mden el repo, con un CLI, un tablero Kanban en la terminal y un servidor MCP. Task Master convierte un PRD en tareas con dependencias, elige la siguiente contask-master nexty añade nuevas conadd-task. Beads, de Steve Yegge, es un grafo de issues con dependencias pensado para agentes, que les da una memoria persistente y estructurada: el agente pide abd readyel trabajo sin bloqueos, lo reclama, y ejecutabd primeal empezar la sesión para cargar su contexto.
La capa del repositorio es la mejor respuesta a «qué hace el agente después en este proyecto». Su límite está en el nombre: vive en un repositorio. Para ver lo pendiente en ocho proyectos tendría que abrir ocho repos.
3. El gestor de issues: issues que los agentes pueden tomar
La tercera capa es la más antigua, el gestor de issues, y es donde las grandes plataformas pusieron a sus agentes en 2025 y 2026. El patrón es el mismo en todas: la issue es la unidad de trabajo, asignarla es la forma de pasársela a un agente, y el resultado vuelve como un pull request.
- GitHub. Puedes asignar una issue a Copilot como a un compañero, y asignar una issue siempre crea un pull request. Las sesiones se siguen en mission control, que en enero de 2026 pasó a ser una pestaña Agents en cada repositorio, junto al código, los pull requests y las issues. GitHub Projects muestra las mismas issues como tabla, tablero o roadmap, y sus automatizaciones integradas marcan un elemento como Done cuando se cierra o se hace merge de su PR.
- Linear. Linear for Agents (mayo de 2025) convirtió a los agentes en usuarios de primera clase en Linear. Se delega una issue asignándola: el agente pasa a ser el delegado y una persona sigue siendo la responsable. Cursor, Codex de OpenAI y Devin toman issues de Linear así (Cursor: asigna cualquier issue a
@Cursor). - Jira. El servidor MCP remoto de Atlassian se lanzó con Anthropic como primer socio y hoy está disponible como Rovo MCP Server. Su agente de código de Jira lleva un elemento asignado hasta un PR en borrador, y no hace merge: se lo devuelve al equipo para revisarlo.
- Desde Claude Code, al revés. No hace falta que el gestor arranque al agente. El servidor MCP de GitHub y el servidor MCP de Linear permiten que una sesión de Claude Code lea el backlog y cree issues a mitad de sesión, y Claude Code GitHub Actions permite escribir
@claudeen una issue para convertirla en un pull request.
El gestor de issues es la única capa que responde mis dos preguntas a la vez: qué falta en todos mis proyectos y dónde pongo una idea para que no se pierda. También es la única que puedo revisar desde el móvil sin clonar nada.
Las tres capas, lado a lado
| Pregunta | Sesión (reanudar en Claude Code, memoria) | Repositorio (archivos de progreso, specs, Beads, Backlog.md) | Gestor de issues (GitHub Issues + Projects, Linear, Jira) |
|---|---|---|---|
| ¿Qué acaba de hacer el agente? | Lo mejor: la transcripción completa | Bien: log de progreso, historial de git | Solo lo que dicen el PR y la issue |
| ¿Qué sigue en este proyecto? | Débil | Lo mejor: tareas ordenadas, dependencias | Bien: orden del tablero, etiquetas |
| ¿Qué sigue en todos los proyectos? | No | No, un repo a la vez | Sí: un tablero, una vista por repo |
| ¿Dónde va una idea nueva a mitad de sesión? | Se pierde si no se registra | Un archivo de tarea nuevo, en ese repo | Una issue nueva, desde cualquier lugar |
| ¿Cuánto dura? | 30 días por defecto, una máquina | Lo que dure el repo | Lo que dure la cuenta |
| ¿Quién más lo ve? | Nadie | Quien tenga el repo | Con quien compartas el tablero |
| ¿Pasa trabajo a un agente? | Es el agente | El agente lo lee | Asignando la issue |
Las capas funcionan mejor juntas, y ahí ha llegado más o menos la industria: un gestor de issues para el qué y el qué sigue, archivos en el repo para el plan de la funcionalidad en curso, y la sesión para el trabajo en sí.
Mi configuración: el tablero recuerda
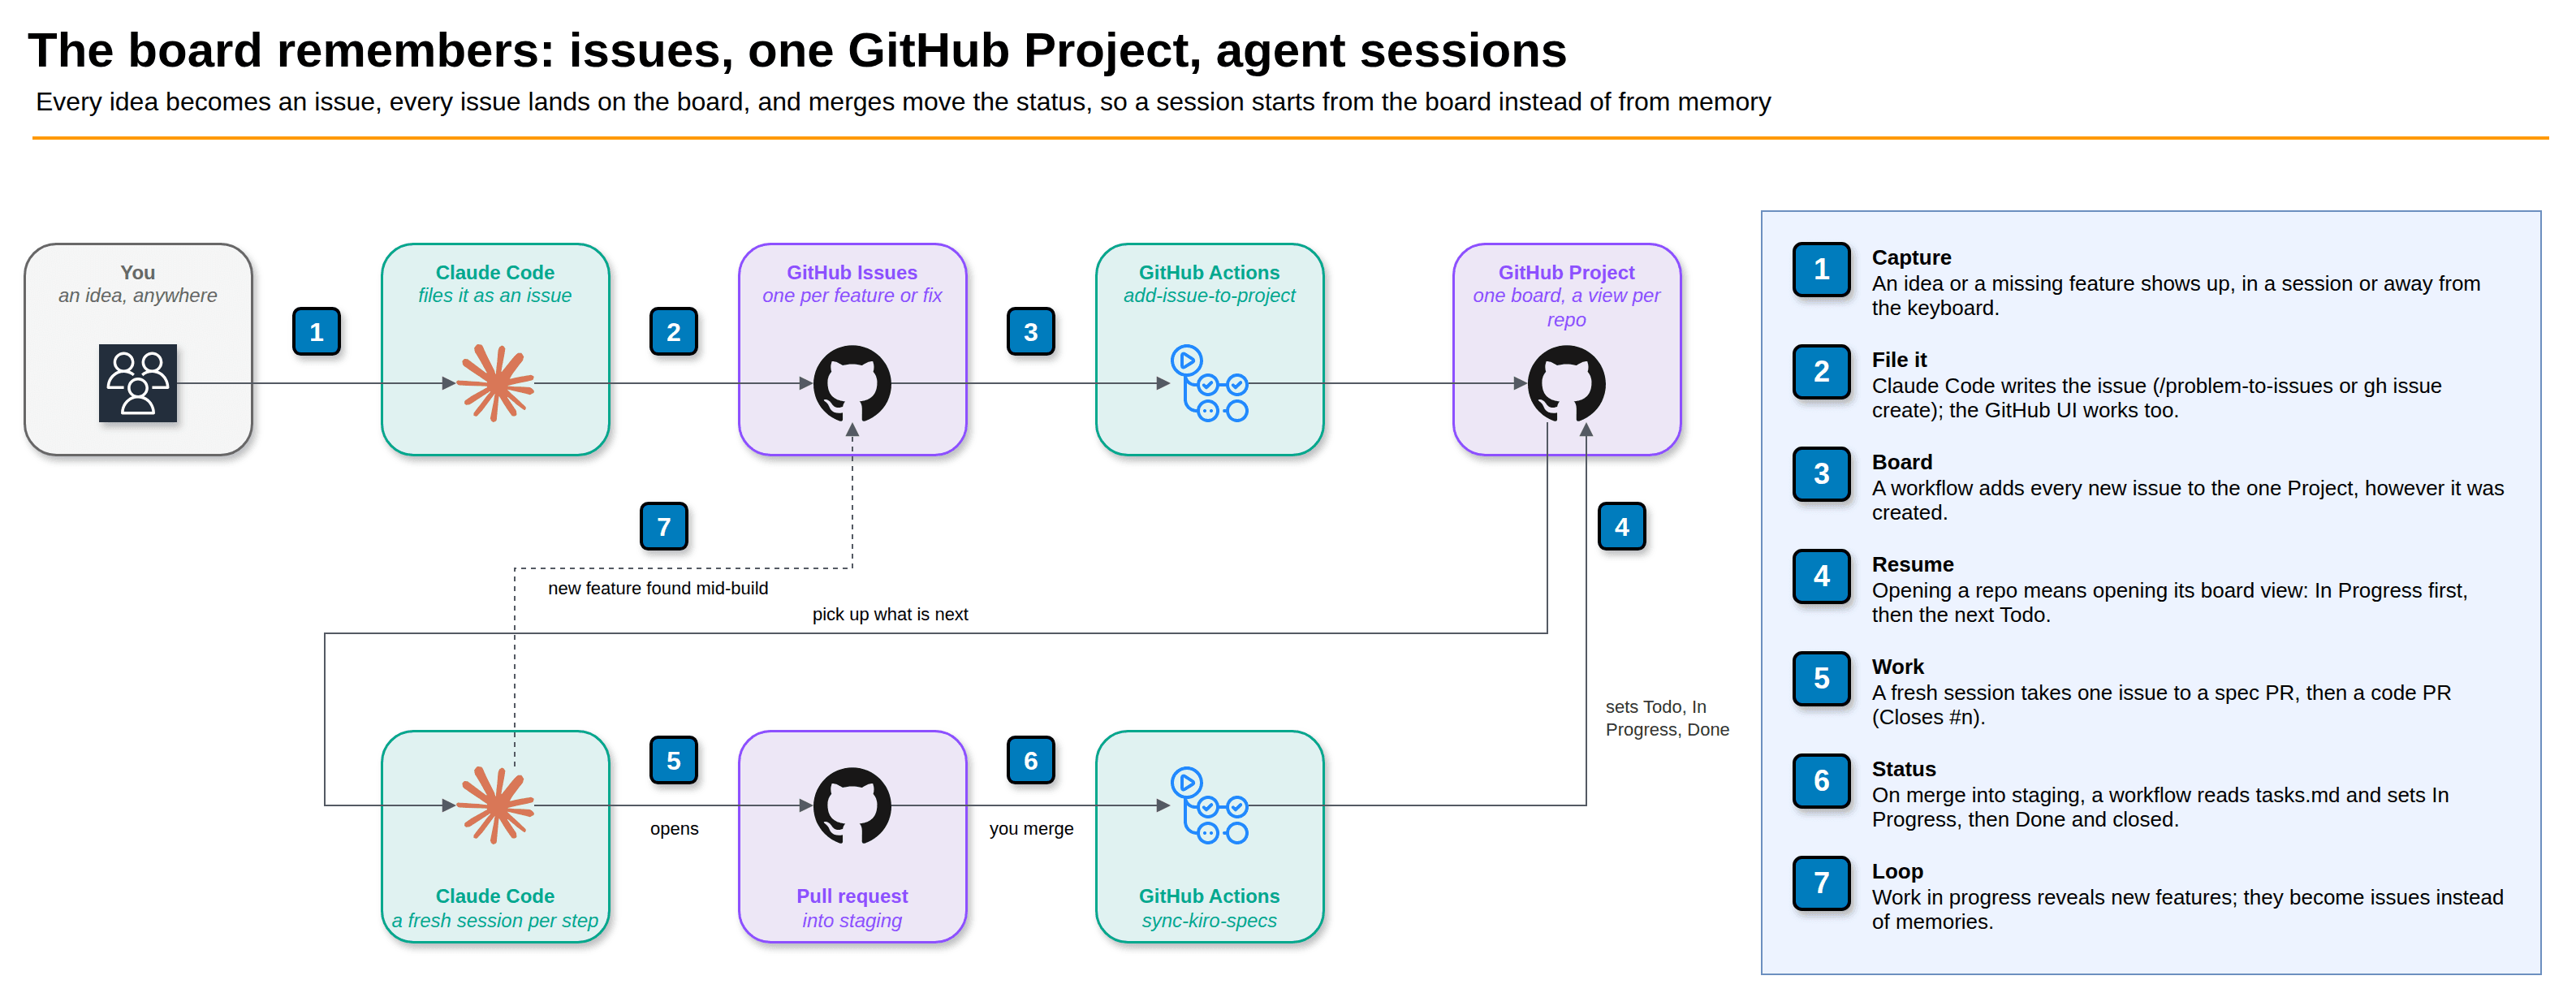
Todo vive en un solo GitHub Project, AI Coding Planner, con una vista de roadmap para todos los proyectos y una vista guardada por repositorio (repo:<owner>/<repo>). Hoy tiene 251 issues de 8 repositorios: 195 Done, 9 In Progress y 47 Todo. Las reglas están en projects-workflow-ai, el repo desde el que arranca cada proyecto, y el proceso completo está en cómo entrego software.
Capturar. Cuando aparece una idea o falta una funcionalidad, se convierte en issue de inmediato, normalmente sin salir de la sesión. /problem-to-issues convierte la descripción de un problema en issues revisadas y las crea con gh cuando las apruebo; para una sola idea basta gh issue create. Un workflow, add-issue-to-project, añade cada issue nueva al tablero desde el lado de GitHub, así que llega sin importar cómo se creó: desde Claude Code, el CLI, la web o el móvil.
Retomar. Volver a un proyecto después de días significa abrir su vista del tablero, no mi memoria. In Progress es lo que estaba haciendo; lo primero de Todo es lo que sigue. La sesión empieza desde la issue: /spec-from-issue 42 escribe o modifica la spec de la funcionalidad, y una sesión nueva ejecuta /implement-tasks sobre ella. El agente nunca necesita que le vuelva a contar la historia, porque la issue, la spec y la lista de tareas son su contexto. Los mismos pasos también pueden correr solos, como recetas de Kiro Workflows que se detienen en un pull request abierto.
Un estado que nadie tiene que acordarse de actualizar. Un segundo workflow se ejecuta en cada merge a staging que toca una spec. Lee la sección de cada issue en tasks.md antes y después del push: tareas nuevas mueven la issue a In Progress, y todas las casillas marcadas la mueven a Done y la cierran. El tablero refleja lo que se ha integrado, no lo que dije que haría.
Una lección de la fontanería. El workflow de estado encontraba el elemento del tablero de una issue listando los elementos del proyecto. En agosto de 2026 el proyecto pasó de 100 elementos, la consulta solo devolvía la primera página, y cada issue más nueva aparecía como «no encontrada en el proyecto»: las ejecuciones salían en verde y nunca se escribía ningún estado. Ahora busca el elemento desde la issue. Un tablero que deja de actualizarse en silencio es peor que no tener tablero, así que el arreglo vino con una prueba que simula el límite de página. (El token que usan esos workflows tiene su propia historia: el token de GitHub que mi repo público nunca debió tener.)
Una excepción. Mi proyecto de videojuego, World Rift Conflict, usa a propósito AWS AI-DLC en su lugar, que guarda su propio archivo de estado y registro de auditoría por cada pieza de trabajo: la capa del repositorio en su forma más pura. Cómo recuerda entre sesiones está en la parte 14, las capas de memoria.
Cómo se compara la mía y qué tomo prestado
Mi configuración es la capa del gestor de issues sobre GitHub, con la capa del repositorio (specs al estilo de Kiro y tasks.md) para la funcionalidad en curso, y la de sesión solo para la sesión misma. Comparada con el resto:
- Donde coincide con la industria. La issue es la unidad de trabajo, un agente empieza desde la issue, el resultado es un pull request y una persona hace el merge. GitHub, Linear y Atlassian ofrecen hoy ese patrón, y mi comparación de el AI SDLC de Anthropic, AWS AI-DLC y pstack de Cursor encontró la misma idea en sus artefactos: la cadena de archivos en git es la memoria.
- Donde hace más que lo predeterminado. Las automatizaciones integradas de GitHub solo conocen cerrada, merge hecho y añadida. La mía también conoce empezada, porque lee las tareas de la spec, y maneja una issue posterior que modifica una funcionalidad existente.
- Donde se queda corta. Una issue dice qué; no dice dónde me detuve. El plan listo para retomar de Leroy y Glomb es exactamente la pieza que falta, así que será el próximo cambio en mis skills: una sesión que se detiene a mitad de una issue deja un comentario breve en ella con lo que está hecho, lo que sigue y lo primero que hay que revisar. Los programadores de Parnin y Rugaber hacían lo mismo con TODOs y errores de compilación a propósito.
- Lo que añadiría para ejecuciones largas de agentes. Para un trabajo que abarca muchas sesiones dentro de una funcionalidad, el archivo de progreso y la lista de funcionalidades que empiezan fallando de Anthropic son baratos y probados, y conviven con
tasks.mdsin reemplazarlo. - Lo que no adopto todavía. Asignar issues a Copilot, o Linear y Beads como un segundo gestor. El valor de un solo tablero es que es uno solo; un segundo lugar donde mirar trae de vuelta el problema que resuelve.
¿Cuál deberías usar?
- Un proyecto, unos días cada vez: la capa de sesión basta. Nombra las sesiones largas y retómalas; guarda las reglas en
CLAUDE.mdoAGENTS.md. - Un proyecto, ejecuciones largas de agentes: añade la capa del repositorio: un archivo de progreso y una lista de tareas que el agente lee primero (el harness de Anthropic, Spec Kit, specs de Kiro, Backlog.md o Beads).
- Varios proyectos, o ideas que llegan en cualquier momento: añade un gestor de issues, con la captura en un solo comando y el estado automático. Si ya vives en GitHub, Issues más un Project con una vista por repo no cuesta nada extra y funciona con Claude Code mediante
ghy el servidor MCP de GitHub. Si tu equipo vive en Linear o Jira, ambos aceptan ya agentes como asignados.
Elijas lo que elijas, la investigación dice dos cosas: escribe el siguiente paso antes de parar, y guárdalo donde vayas a mirar primero. Para mí, ese lugar es el tablero.